Ефективно планиране за GPU клъстери



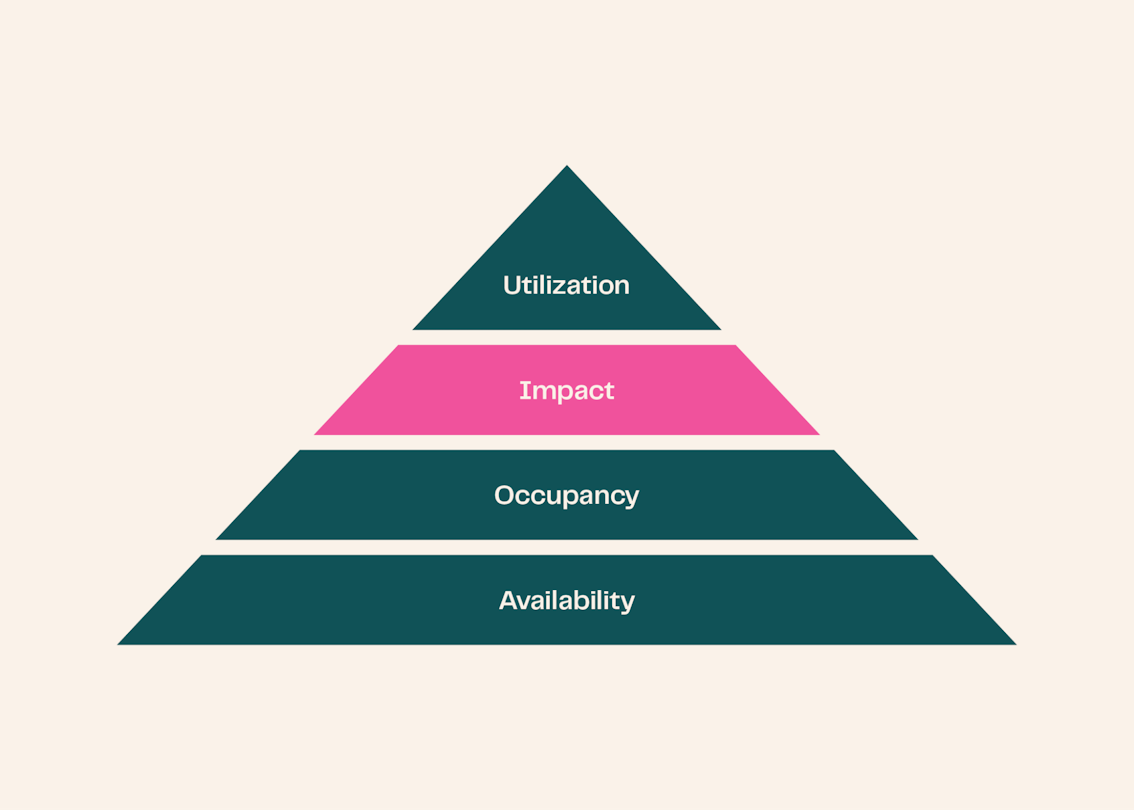
В екипа по AI инфраструктура на Ai2 отговаряме за предоставянето на GPU изчислителния капацитет на института, като се фокусираме по-специално върху големи, разпределени работни натоварвания за обучение. Разглеждаме тази задача като пирамида от четири показателя, които се надграждат един върху друг.
Основата е достъпността: колко често хардуерът е изправен и готов за работа. Над нея е заетостта: делът от наличното време, зададен за конкретно работно натоварване. Следва въздействието: колко често най-ценните работни натоварвания са избирани да получат ресурси. Върхът на пирамидата е използването: делът от GPU капацитета, използван през целия живот на дадено работно натоварване.
Тази публикация е посветена на подобряването на въздействието на решенията ни за планиране. Наскоро заменихме планировчик, базиран на приоритети, със система, включваща бюджети за GPU време, йерархично разпределение на справедлив дял и договор за разделяне на времето. В резултат изместихме дебата за това колко GPU време заслужава всеки изследователски проект – от оперативна задача, решавана за всеки отделен случай, към прозрачен административен процес за бюджетиране.
Прекомерно ангажиране
В Ai2 управляваме хиляди NVIDIA H100, B200 и B300 GPU, разпределени в клъстери с размер от 88 до 1024 GPU. Тези клъстери са създадени за широкомащабно разпределено обучение на AI модели и обслужват група от около 150 вътрешни изследователи, чиято работа обхваща разнообразни области на AI, включително целия процес на обучение на LLM и VLM модели, симулации за обучение с подсилване (RL) в роботиката и дообучение за научни агентни приложения.
Както много лаборатории, ние имаме търсене на GPU време, което значително надвишава предлагането. Въз основа на подадените работни натоварвания във всеки момент имаме неизпълнени заявки за 2–3 пъти повече GPU от наличните. Един от начините да разглеждаме това е, че всеки наличен GPU час в клъстера ни има 2–3 различни изследователски работни натоварвания, които се конкурират за него.
Исторически използвахме планировчик, базиран на приоритети, и позволявахме на работните натоварвания да се откажат от възможността за прекъсване. Всеки екип имаше ограничение за броя едновременни GPU, които можеха да бъдат използвани от натоварвания, защитени от прекъсване. Натоварванията, подлежащи на прекъсване, можеха да надхвърлят този лимит върху неактивни GPU. Тази стратегия пораждаше предвидими проблеми. Например наблюдавахме случаи на „окупиране“ на GPU, при които потребители оставяха фиктивни натоварвания, към които можеха да се свържат при нужда. Това се случваше, защото изследователите установяваха, че не могат да стартират натоварвания за отстраняване на грешки с достатъчно малко закъснение, за да се справят с проблемите в реално време. Наблюдавахме и инфлация на приоритетите, при която в крайна сметка 100% от планираните натоварвания използваха приоритет HIGH. Това означаваше, че по-ниските нива на приоритет изобщо не получаваха GPU време. Тъй като възможността за прекъсване беше опционална, установихме също, че дежурните ни инженери прекарват по-голямата част от времето за отговор на заявки в преговори за организирано спиране на натоварвания без възможност за прекъсване, работещи на хостове с известни проблеми, изискващи поддръжка.
Трагедията на общите ресурси
Когато тези проблеми се появиха, бавно идентифицирахме първопричините им. Първоначалните ни опити да гарантираме, че най-важната работа ще получи GPU време, бяха насочени към по-строг контрол върху задаването на приоритети и в крайна сметка към заобикаляне на планировчика, базиран на приоритети, чрез изрично предоставяне на монопол върху GPU на важни проекти. Макар първоначално да не го осъзнавахме, бяхме създали перфектна лаборатория за наблюдение на „трагедията на общите ресурси“. Отделни хора се конкурираха за оскъден споделен ресурс и, стремейки се да увеличат максимално индивидуалните резултати, постигаха неоптимален глобален резултат и злоупотребяваха с основния ресурс.
Далеч не бяхме първите, които наблюдават подобно взаимодействие. Разпределението на ресурсите е завладяваща изследователска област, която съчетава разработване на алгоритми, икономика и управление на системи. Основен проблем е, че потребителите често познават стойността на собствените си задачи по-добре от организацията, но може да имат стимул да прикриват тази стойност или да задържат ресурси, дори когато това вреди на общата производителност. Например в статията си от 2011 г., с която въвеждат справедливостта спрямо доминиращия ресурс, Ghodsi и съавтори разказват анекдот, според който компания за търсачки предоставяла специализирани машини за задачи само ако потребителите им можели да гарантират висока степен на използване. Скоро открили, че „потребителите поръсвали кода си с безкрайни цикли, за да надуват изкуствено нивата на използване“. Хардуерът се променя, но фундаменталните проблеми, които правят разпределението на ресурсите сложно, остават.
Бюджети, а не графици
Класическото решение на трагедията на общите ресурси е приватизирането на споделения ресурс – собствениците имат стимул да увеличат стойността на своята собственост. Когато предоставяхме на екипи монопол върху групи GPU, вече правехме нещо подобно, но твърде грубо. Това водеше до бездействие на GPU поради сезонността на изследванията. Екипите са готови да провеждат експерименти и обучения по различно време, така че предоставянето на монопол гарантираше периоди, в които нямаше готови за изпълнение задачи, докато друг екип чакаше капацитет.
Ръчно решавахме задача за раницата, опитвайки се да вместим динамично променящите се изследователски нужди в статичен график. Искахме стимула на собствеността, но също така искахме да поддържаме пълна заетост на GPU.
Решихме да усъвършенстваме модела на собствеността. Вместо да предоставяме GPU на екипите, избрахме да разпределяме дял от GPU времето. Прогнозирането на бъдещото търсене би изисквало да знаем резултата от нови научни експерименти, така че то не може да бъде предвидено с прецизност. Приоритетът между изследователските начинания обаче е стратегически въпрос и може по-лесно да бъде обсъден и решен предварително. Вместо да се опитваме да решим пъзела на планирането, дадохме възможност на ръководството да мисли като инвеститор. Преди да съществуват работните натоварвания, да се реши как да се финансира всяко изследователско начинание с GPU време въз основа на преценката за вероятното му въздействие. След това планировчикът можеше да използва тази информация при приоритизирането на постъпващите натоварвания.
С оглед на това създадохме йерархична система, в която мениджърите можеха пропорционално да разпределят GPU време между проектите и изследователите, за които отговарят. Както показва диаграмата по-долу, това превръща програмната стратегия директно в гарантиран дял от GPU време. Проект A1 знае, че има право на 35% от общия капацитет, независимо от броя на другите проекти, които се нареждат на опашка някъде другаде.
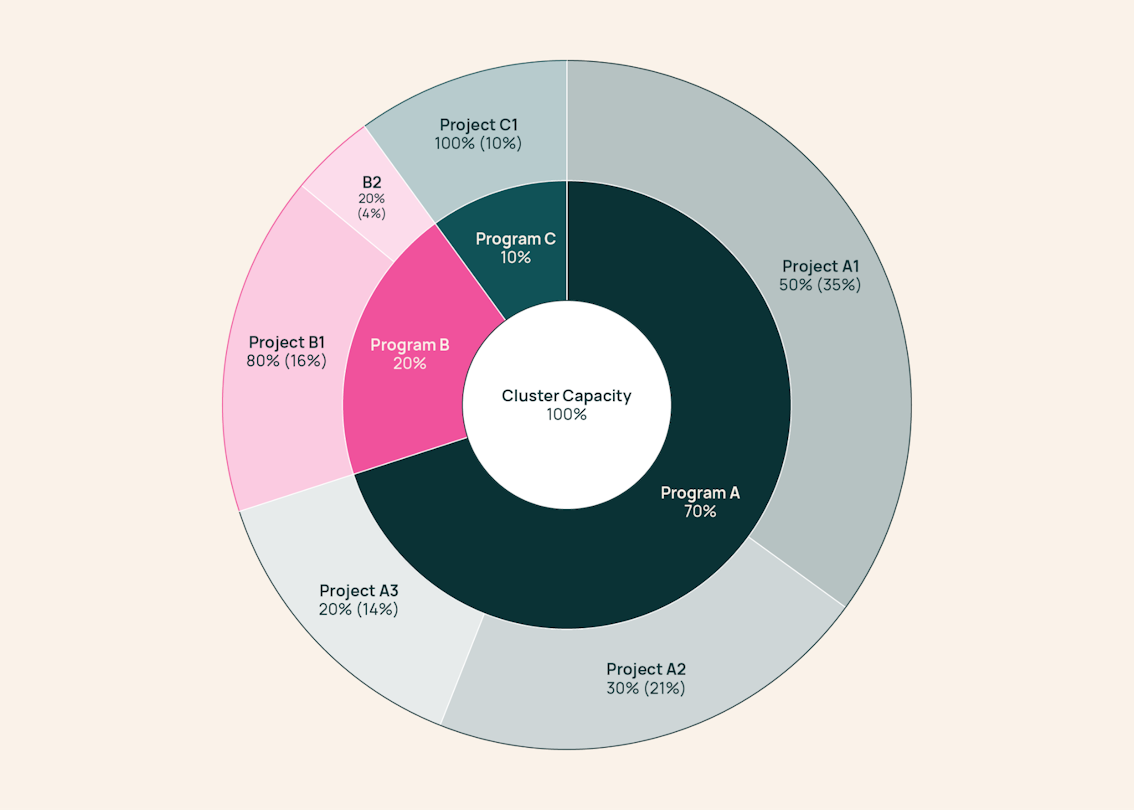
Стойностите в скоби представляват общия капацитет на клъстера, предоставен на краен проект.
В тази система всяка заявка за GPU време трябва да бъде финансирана от бюджет, иначе не е защитена от прекъсване. В старата система приоритетът HIGH не носеше разход, а невъзможността за прекъсване позволяваше на екипа да запълва неограничено своя лимит за едновременни GPU, така че всички ги използваха. Сега нищо не е безплатно, така че всеки трик за получаване на GPU време се приспада от разпределението на потребителя, който извлича полза. Натоварване, което просто заема ресурс, изразходва бюджета на екипа за нищо. Стратегията ни е да направим използването на хитрини срещу планировчика по-скъпо от честното участие в дебата за по-голям бюджет. Постоянно усъвършенстваме този процес на преглед на бюджетите, но ключовите изисквания са изследователите да имат чести възможности да защитят необходимото им време, а решенията да се вземат от мениджъри с най-добър контекст за съответните компромиси. Това означава, че решенията за разпределение в рамките на изследователски проект се вземат от водещ изследовател, в рамките на изследователска програма – от главен изследовател, а между програмите – от водещ програмен мениджър или от изпълнителния директор.
Справедлив дял
Заедно с този инструмент за бюджетиране на GPU време изградихме йерархичен планировчик за справедлив дял, който управлява действителната заетост на разпределените ресурси в цялото дърво на програмите. Алгоритъмът тук не е нов – йерархичният справедлив дял за определен времеви прозорец е част от линия разработки, водеща до Fair Scheduler на Hadoop от 2009 г., а същият подход се използва активно и днес в Fair Tree на SLURM и Fair Scheduler на YARN. Новото за нас са входните данни: дървото отразява структурата на изследователските програми, а теглата са бюджети, зададени от мениджъри, а не статични квоти.
Планировчикът проследява заетостта в плъзгащ се прозорец заย้อนหลัง (по подразбиране 7 дни) и подрежда работните натоварвания от тези с недостатъчно използвани разпределения пред тези с прекомерно използвани разпределения. Така в рамките на едноседмичен период можем да очакваме всяка група да получи разпределеното ѝ GPU време, стига активно да подава работни натоварвания с достатъчно търсене.
„Новият планировчик създава усещането, че разполагаме с още 30% изчислителен ресурс. При стария планировчик, ако имахме моменти, в които не се нуждаехме от целия си лимит, този ресурс на практика се губеше. Сега с новия планировчик, ако това се случи, по-късно можем да надхвърлим лимита си за разпределение и пак да виждаме задачите си планирани бързо и без прекъсване, което на практика ни позволява да си върнем този ресурс. Нашите работни натоварвания често са импулсни, така че това ни върна значително количество изчислителен ресурс.“ — Chris Clark
Планировчикът различава два вида заетост. Разпределената заетост е времето, през което дадено работно натоварване се таксува към бюджет. То се приспада от разпределенията на собственика на натоварването, което влияе върху изчислението на бюджета за справедлив дял, а тези натоварвания са защитени от прекъсване в рамките на минималния си времеви прозорец на изпълнение. Неразпределената заетост не се таксува към бюджет, не е защитена от самото начало и може да бъде прекъсната от всяка разпределена заявка. Това ни позволява да поддържаме GPU напълно заети, дори когато разпределенията не съответстват добре на търсенето, и не позволява на екипите никога да отказват безплатни GPU цикли.
Договорът за планиране
Допълнителна характеристика на разпределеното обучение, която затруднява справедливото разпределение на ресурсите, е, че работните натоварвания могат да се изпълняват много дълго. Задачите за обучение редовно работят часове, дни, а понякога и седмици. След като бъде планирано, едно натоварване може да остане върху зададените му GPU за седмица или повече, без да предостави възможност на други да получат бюджетираното си време. Именно това свойство на системата направи възможно окупирането на GPU. То също принуждаваше дежурните инженери да преговарят със собствениците на дълго работещи задачи за решаване на текущи проблеми по поддръжката.
За да се справим с тези проблеми, въведохме „договор за планиране“. В замяна на достъп до клъстера работното натоварване трябва да декларира минималното си време на изпълнение, тоест най-краткия период на заетост, необходим за постигане на съществен напредък. През това време натоварването е защитено от прекъсване. Това дава на изследователя гаранция за напредък, като същевременно предоставя на планировчика правото да балансира отново ресурсите, след като този напредък бъде натрупан, като автоматично поставя отново на опашката възобновимите натоварвания. Като алтернатива потребителят може да зададе минимално време на изпълнение, равно на нула, което показва, че GPU времето трябва да бъде неразпределено. Тези натоварвания винаги подлежат на прекъсване, но са и безплатни в смисъл, че не се таксуват към бюджет.
Жизненият цикъл на работното натоварване следва този модел:
- Натоварването се изпраща с минимално време на изпълнение и указание дали може да бъде възобновено.
- Натоварването се планира според алгоритъма за справедлив дял, претеглен чрез съотношението между действителната заетост и разпределеното време в прозореца заย้อนหลัง.
- Натоварването се изпълнява за минималното си време, което се приспада от разпределенията му.
- Натоварването може да продължи да се изпълнява, докато свързаните разпределения продължават да го приоритизират пред други. Това време също се приспада от разпределенията му.
- То може да бъде прекъснато и поставено отново на опашката, което връща процеса към стъпка 2.
- Натоварването приключва и освобождава заявката си към всички ресурси.
Заедно тези споразумения добавят разделяне на времето към нашия планировчик. Изпълняващите се натоварвания могат да бъдат премахвани и автоматично поставяни отново на опашката, което позволява на справедливия дял да се сближи и обезкуражава окупирането на ресурси. Те също така позволяват на нездравите хостове да освобождават натоварванията си, когато те достигнат минималното си време на изпълнение, така че дейностите по ремонт да бъдат напълно автоматизирани. Този последен аспект се оказа по-важен, отколкото осъзнавахме при планирането на тази работа. Той намали с 74% ремонтите, изискващи човешка намеса, което доведе до огромни спестявания на дежурен труд.
Симулации
Знаем, че промените в политиката за планиране могат да имат непредвидени последици. Нулевата сума на проблема означава, че предоставянето на време на един изследовател означава отнемането му от друг. Потребителите, които губят при този обмен, обикновено търсят нови заобиколни решения. Преди внедряването на системата, базирана на бюджети, искахме бърз начин да предвидим къде могат да възникнат по-дълги времена за изчакване и да тестваме настройки като дължината на прозореца заย้อนหลัง или максималната стойност на минималното време на изпълнение (избрахме 8 часа).
Изградихме малка симулационна среда, която приема като вход набор от работни натоварвания и графика им за подаване и позволява на планировчика да взема решения за прекъсване и разпределяне на GPU. С информацията за заявения брой GPU и общото време на изпълнение на всяко натоварване симулаторът можеше да прескача до моменти, в които е възможно планиране, и за няколко секунди да предоставя анализ на времето за изчакване на опашката, събитията на прекъсване и разпределението на GPU времето между проектите за много симулирани дни. Стартирахме симулатора както с исторически данни за подаване, така и със създадени сценарии, които искахме да разберем по-добре.
Една от хипотезите, които искахме да проверим, се отнасяше до „натоварванията за отстраняване на грешки“. Тези задачи изискват малък брой GPU и минимално време на изпълнение от 15 минути или по-малко, което е достатъчно за потребителя да види дали дадена задача се стартира успешно или се срива в началото поради грешка или неправилна конфигурация. Искахме да разберем дали тези задачи ще имат по-кратко време за изчакване на опашката от по-големите натоварвания за обучение, които често се нуждаят от много GPU и часове изпълнение, за да постигнат съществен напредък. Интуитивно тези по-малки задачи би трябвало да се изкачат най-отпред на опашката, тъй като една малка задача може да се вмести на повече места от голяма. Но точното закъснение на опашката беше важно. Кратко изчакване от минута-две би отключило нова практика за разработка, но десетминутното изчакване става неприемливо.
Симулациите ни изискваха ръчно създадени тестови данни, тъй като историческият ни архив не съдържаше достатъчно голям обем от подобни на натоварвания за отстраняване на грешки задачи. Резултатите ни потвърдиха хипотезата, като показаха, че p90 времето за изчакване на такива натоварвания намалява от около 6 часа до само 5 минути.
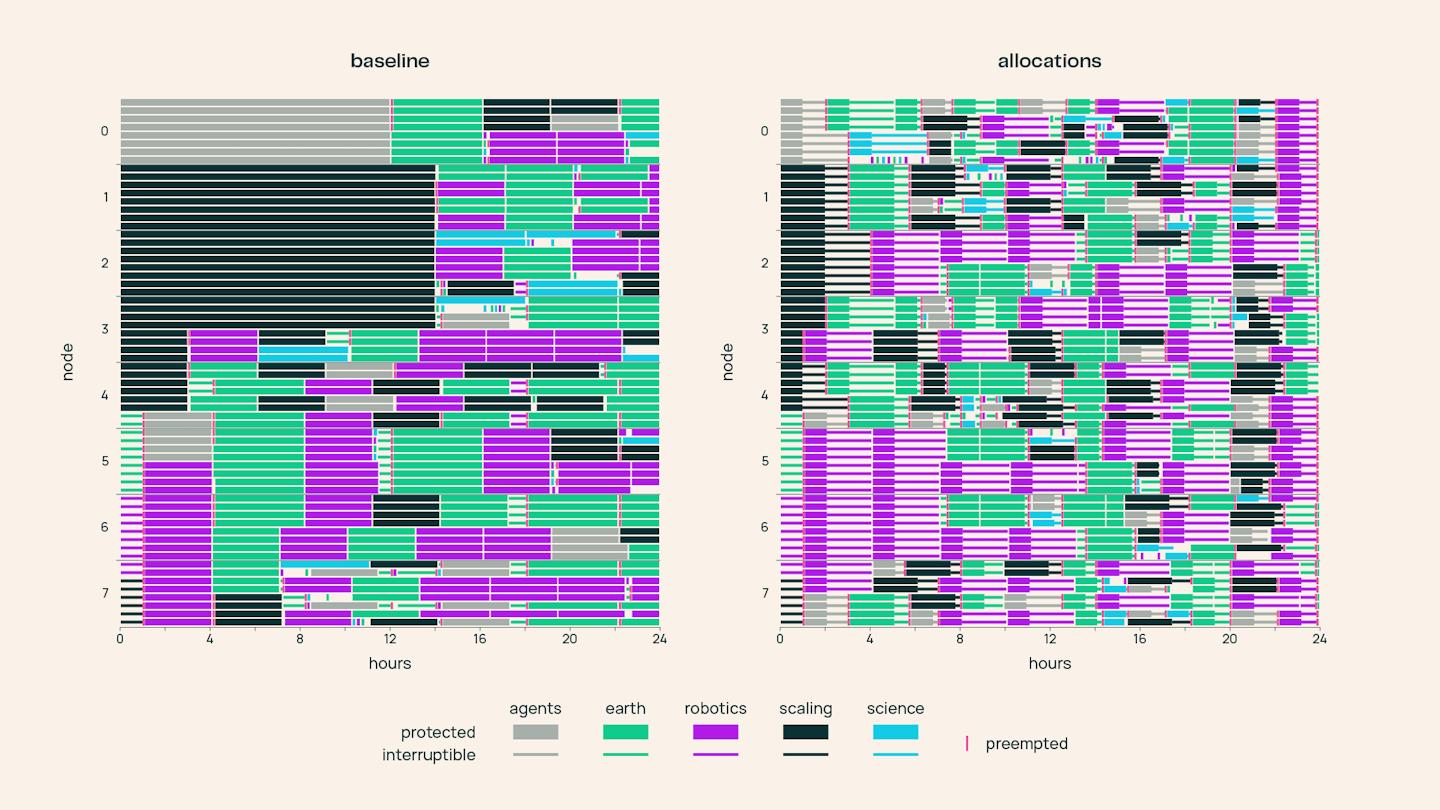
Визуализация от симулатора в по-малък мащаб на базовия планировчик (вляво) и новия планировчик „разпределения“ (вдясно). Всеки ред е един GPU; всяка лента е задача, оцветена според родителското натоварване, като всеки екип има отделен цветови нюанс; щриховката обозначава времето, през което задачата може да бъде прекъсната, а червеният ръб показва прекъсване. При базовия планировчик дългите спешни задачи никога не се прекъсват и има по-малко прекъсвания при работата с по-нисък приоритет. Новият планировчик има по-голямо смесване на цветове върху всеки GPU, което показва ротация на заетостта между екипите.
Резултати
След като разполагахме с резултатите от симулациите, в края на юли започнахме внедряване клъстер по клъстер. Резултатите, които ни интересуват, са дали работните натоварвания, които избрахме да финансираме, са получили своето време, дали новата система е поддържала пълна заетост и дали изследователите са могли да разсъждават върху планировчика, за да вземат информирани решения.
След внедряването наблюдаваме, че потребителите и екипите постоянно получават разпределеното им GPU време. Отчитаме времето, което се дължи на даден екип, като неговото разпределение, ограничено всеки час до действителното му търсене. За 30-дневния тестов период екипите са получили 98% от дължимите им GPU часове, а 13 от 15 разпределения на екипи са получили 95% или повече, като най-лошият случай е 90%. Заетостта на клъстера се запази на 98% преди и след промяната, при търсене, надвишаващо капацитета 2–3 пъти и през двата периода. 18% от предоставеното GPU време беше неразпределено, което е начинът, по който поддържахме висока заетост в периоди, когато финансираните случаи на използване не бяха готови за изпълнение.
Резултатите от симулатора ни се оказаха точни по посока, като реалните резултати надминаха прогнозите ни. p90 времето за изчакване на опашката при натоварванията за отстраняване на грешки намаля от 2 часа на 30 секунди при новия планировчик, в сравнение със симулираната прогноза от 6 часа до 5 минути въз основа на ръчно създадени тестови сценарии. Важно е да се отбележи, че по-малкият брой натоварвания за отстраняване на грешки при базовия планировчик означаваше по-висока вариативност в тези измервания. Закъснението на опашката като цяло се подобри като страничен ефект от разделянето на времето: в най-големия ни H100 клъстер медианното време за изчакване на опашката спадна от 5 минути на 24 секунди, а p90 времето за изчакване намаля с около една трета – от 2,8 часа на 1,8 часа.
В сравнение с трите проблема, които си поставихме за цел да решим:
Окупиране: Кратките натоварвания за отстраняване на грешки стартират за по-малко от минута, което намалява стойността на окупирането. Цената на това поведение се приспада от бюджета на окупатора, което му пречи да получи време, когато действително има нужда от него.
Инфлация на приоритетите: Все още позволяваме на натоварванията да декларират приоритет, но той влияе само върху подреждането в рамките на екипа. Мениджърите имат стимул да наблюдават приоритетите в групата, за да оптимизират използването на бюджетите си.
Дежурен труд: Нездравите хостове се освобождават автоматично, когато натоварванията достигнат минималното си време на изпълнение. Ремонтите, изискващи човешка намеса, намаляха със 74%.
Предизвикателства
Кривата на обучение беше по-стръмна, отколкото предполагахме. Внедрявахме промяната поетапно, така че в началото изследователите изпитваха различно поведение в зависимост от клъстера, към който се насочваха. Освен това интерфейсите ни запазиха някои стари термини, като приоритета на работното натоварване, чието значение се беше променило. Самата документация не разреши объркването. Това, което проработи, беше провеждането на разяснителни сесии на живо, осигуряващи форум за задаване на въпроси от изследователите и възможност инженерният екип да даде по-задълбочени описания както на това как, така и защо планировчикът взема решенията си за приоритизиране, използвайки реални примери.
Това беше ключов момент, защото отбеляза прехода от ранен период на неудовлетвореност и непроверени теории към настоящия режим, при който изследователските групи комуникират по-често и по-широко относно GPU нуждите на своите експерименти. Сега изследователите участват в дискусиите за бюджетите с по-ясно разбиране на компромисите, необходими за удовлетворяване на всяка нова заявка.
В допълнение към присъствените сесии след старта въведохме нови визуализации, за да дадем на потребителите по-добра представа доколко зададеното им GPU време съответства на очакваните им разпределения и директно да покажем показателя, използван за подреждане на опашката от работни натоварвания. Това осигури лесно място за проверка, когато дадено натоварване бъде прекъснато, за да се разбере защо. Тези визуализации помогнаха и на собствениците на бюджети, които можеха да видят как се използва GPU времето в различните проекти под тяхно управление.
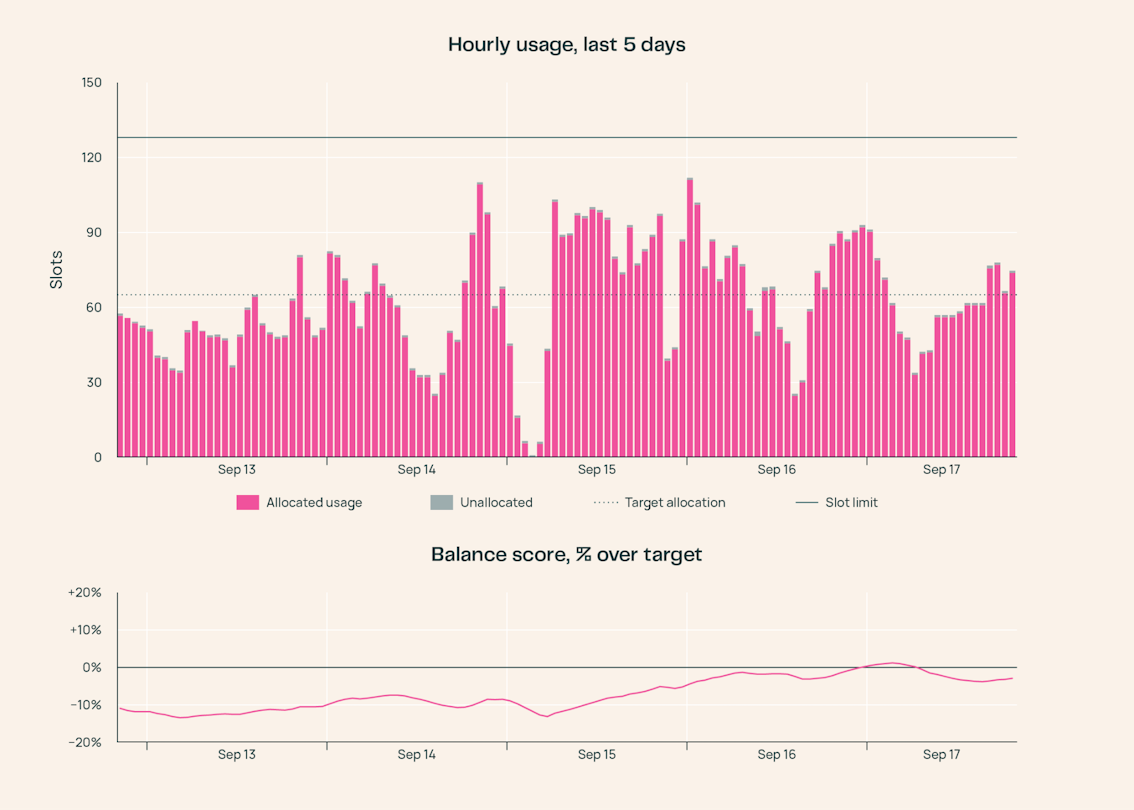
Примерна визуализация на използването на разпределението във времето.
Не всеки случай на използване се подобри. В допълнение към разпределеното обучение нашите изследователи стартират интерактивни сесии, в които извършват анализ на данни и тестват код за обучение, докато го пишат. В старата система изследовател можеше да поддържа такава сесия до една седмица. При разделянето на времето те бяха подчинени на 8-часовия лимит за защитено време на изпълнение, след което сесията ставаше подлежаща на прекъсване, ако надхвърлеше разпределението си. Не бяхме осъзнали до каква степен изследователите зависеха от променливото състояние на тези сесии. Прекъсването означаваше изчакване за осигуряване на нова сесия, както и ръчно възстановяване на състоянието. След като проучихме изследователите, за да разберем обхвата на проблема, създадохме два нови проекта в пътната карта. Инвестираме в клъстер само с CPU до локалното ни хранилище за развойни сесии, фокусирани върху задачи по подготовка на данни. Това ще запази капацитета на клъстера за обучение за натоварванията, които действително се нуждаят от него. Освен това планираме да изградим възстановими сесии за тези натоварвания само с CPU. Това ще ни позволи да продължим да прекъсваме натоварванията в края на минималното им време за поддръжка или разделяне на времето, като същевременно можем да възстановим сесията на друго място, без изследователят да я изгражда отново. Така можем да запазим оперативните и планировъчните предимства на новата система, като същевременно подобрим потребителското изживяване.
Продължаваме да следим за възникващи проблеми. Един от потенциалните проблеми, които проучваме, е фрагментацията на капацитета, която може да доведе до увеличаване на времето за изчакване на най-големите натоварвания. Интуицията ни е, че защитата на минималното време на изпълнение се прилага към типовете задачи, които преди разчитаха на механизми за прекъсване, за да надхвърлят лимита на екипа за едновременни GPU. Преди тези задачи можеха да бъдат прекъснати по всяко време, което потенциално губеше това време, но също така улесняваше планирането на големи задачи. Сега планировчикът може да има по-малко възможности да прекъсне много задачи едновременно, за да разположи голямо чакащо натоварване. В момента използваме инструментите си за симулации, за да възпроизведем този проблем, като едновременно измерваме действителното състояние в продукционна среда.
Бъдещето
Когато погледнем отвъд описаната тук работа по планирането, се насочваме към върха на пирамидата: използването. Трябва да гарантираме, че началното зареждане, създаването на контролни точки и самите приложения за обучение се изпълняват възможно най-ефективно, като максимизираме стойността на планираното време, което получава всяко работно натоварване.
Ако искате да се справяте с подобни предизвикателства в тясно сътрудничество с изследователи, ви насърчаваме да разгледате отворените инженерни позиции в Ai2.


Общност
· Регистрирайте се или влезте, за да коментирате
Преведено автоматично от английски. Оригиналната статия е на връзката по-долу.