Ефективне планування для GPU-кластерів



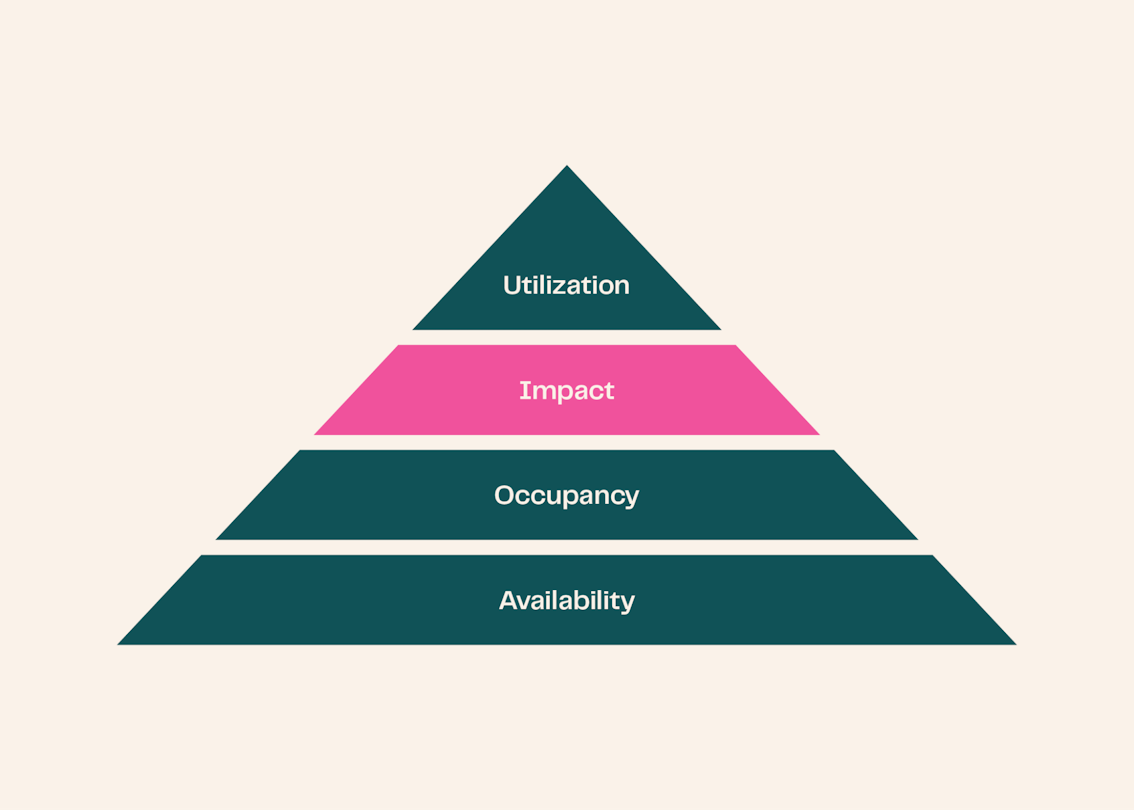
У команді AI-інфраструктури Ai2 ми відповідаємо за забезпечення інституту обчислювальними ресурсами GPU, зокрема для великих розподілених робочих навантажень. Ми розглядаємо це завдання як піраміду з чотирьох метрик, кожна з яких спирається на попередню.
Основою є доступність: як часто обладнання справне й готове до роботи. Вище розташована зайнятість: частка доступного часу, призначеного конкретному робочому навантаженню. Далі — вплив: як часто найцінніші робочі навантаження обираються для отримання ресурсів. Вершиною піраміди є використання: частка обчислювальної потужності GPU, використаної протягом усього життєвого циклу робочого навантаження.
Ця публікація присвячена підвищенню впливу наших рішень щодо планування. Нещодавно ми замінили планувальник на основі пріоритетів системою, що включає бюджети часу GPU, ієрархічний розподіл із чесною часткою та контракт на розподіл часу. У результаті ми змістили обговорення того, скільки часу GPU заслуговує кожен дослідницький проєкт, від операційного завдання, що вирішується окремо в кожному випадку, до прозорого адміністративного процесу формування бюджету.
Надмірне резервування
У Ai2 ми керуємо тисячами GPU NVIDIA H100, B200 і B300, об’єднаних у кластери розміром від 88 до 1024 GPU. Ці кластери призначені для великомасштабного розподіленого навчання моделей ШІ та обслуговують близько 150 внутрішніх дослідників, робота яких охоплює різноманітні сфери ШІ, зокрема весь цикл навчання LLM і VLM, симуляцію навчання з підкріпленням (RL) для робототехніки та післянавчання для наукових агентних сценаріїв використання.
Як і багато лабораторій, ми маємо попит на час GPU, що значно перевищує пропозицію. З огляду на подані робочі навантаження, у будь-який момент ми маємо незадоволені запити на у 2–3 рази більшу кількість GPU, ніж доступно. Один зі способів осмислити це полягає в тому, що за кожну доступну годину GPU у нашому кластері конкурують 2–3 різні дослідницькі робочі навантаження.
Історично ми використовували планувальник на основі пріоритетів і дозволяли робочим навантаженням відмовлятися від можливості переривання. Кожна команда мала ліміт одночасно використовуваних GPU для робочих навантажень, захищених від переривання. Робочі навантаження, які можна було перервати, могли перевищувати цей ліміт на неактивних GPU. Така стратегія породжувала передбачувані проблеми. Наприклад, ми спостерігали випадки «окупації» GPU, коли користувачі запускали порожні робочі навантаження, до яких могли під’єднатися за потреби. Це відбувалося тому, що дослідники виявили: вони не можуть запускати налагоджувальні робочі навантаження з достатньо малою затримкою, щоб розв’язувати проблеми в реальному часі. Ми також спостерігали інфляцію пріоритетів, коли зрештою 100% запланованих робочих навантажень використовували пріоритет HIGH. Це означало, що рівні з нижчим пріоритетом взагалі не отримували часу GPU. Оскільки можливість переривання була необов’язковою, ми також виявили, що наші чергові інженери витрачали більшу частину часу на обробку заявок, домовляючись про організоване завершення роботи непереривних робочих навантажень, запущених на хостах із відомими проблемами обслуговування.
Трагедія спільного ресурсу
Коли виникли ці проблеми, ми не одразу змогли визначити їхні першопричини. Наші перші спроби забезпечити час GPU для найважливішої роботи були зосереджені на жорсткішому контролі встановлення пріоритетів і, зрештою, на обході планувальника на основі пріоритетів шляхом явного закріплення монополій на GPU за важливими проєктами. Хоча спочатку ми цього не усвідомлювали, ми створили ідеальну лабораторію для спостереження за «трагедією спільного ресурсу». Окремі користувачі конкурували за дефіцитний спільний ресурс і, прагнучи максимізувати індивідуальні результати, досягали неоптимального глобального результату та зловживали базовим ресурсом.
Ми були далеко не першими, хто спостерігав таку взаємодію. Розподіл ресурсів — захоплива галузь досліджень, що поєднує розробку алгоритмів, економіку та системне управління. Центральна проблема полягає в тому, що користувачі часто краще за організацію знають цінність власних завдань, але можуть мати стимули приховувати цю цінність або утримувати ресурси, навіть коли це шкодить загальній продуктивності. Наприклад, у своїй статті 2011 року, де було представлено справедливість домінантного ресурсу, Годсі та його співавтори наводять історію про те, як пошукова компанія надавала завданням виділені машини лише за умови, що їхні користувачі могли гарантувати високе використання. Незабаром вони виявили, що «користувачі додавали до свого коду нескінченні цикли, щоб штучно підвищити рівні використання». Обладнання змінюється, але фундаментальні проблеми, які ускладнюють розподіл ресурсів, залишаються.
Бюджети, а не розклади
Класичне рішення трагедії спільного ресурсу — приватизувати спільний ресурс: власники отримують стимул максимізувати цінність свого майна. Коли ми надавали командам монополії на набори GPU, ми вже застосовували варіант цього підходу, але він був надто грубим. Через сезонність досліджень GPU простоювали. Команди готові запускати експерименти й навчання в різний час, тому призначення монополії гарантувало б періоди, коли жодне завдання не було готове до виконання, тоді як інша команда чекала б на потужності.
Ми вручну розв’язували задачу про рюкзак, намагаючись вписати динамічно змінні дослідницькі потреби в статичний розклад. Ми хотіли зберегти стимул власності, але водночас підтримувати повну зайнятість GPU.
Ми вирішили вдосконалити модель власності. Замість того щоб видавати командам GPU, ми вирішили розподіляти частину часу GPU. Прогнозування майбутнього попиту вимагало б знання результатів нових наукових експериментів, тому його неможливо точно передбачити. Однак пріоритетність дослідницьких напрямів є стратегічним питанням, яке легше обговорити й визначити заздалегідь. Замість спроб розв’язати головоломку планування ми дали керівництву змогу мислити як інвестори. Ще до появи робочих навантажень потрібно вирішити, як фінансувати кожен дослідницький напрям часом GPU, спираючись на оцінку його ймовірного впливу. Тоді планувальник міг би використовувати цю інформацію під час визначення пріоритетів нових робочих навантажень.
З огляду на це ми розробили ієрархічну систему, у якій керівники могли пропорційно розподіляти час GPU між проєктами та дослідниками, за яких вони відповідали. Як показано на схемі нижче, це безпосередньо перетворює стратегію програми на гарантовану частку часу GPU. Проєкт A1 знає, що має право на 35% загальної потужності незалежно від того, скільки інших проєктів стають у чергу в інших місцях.
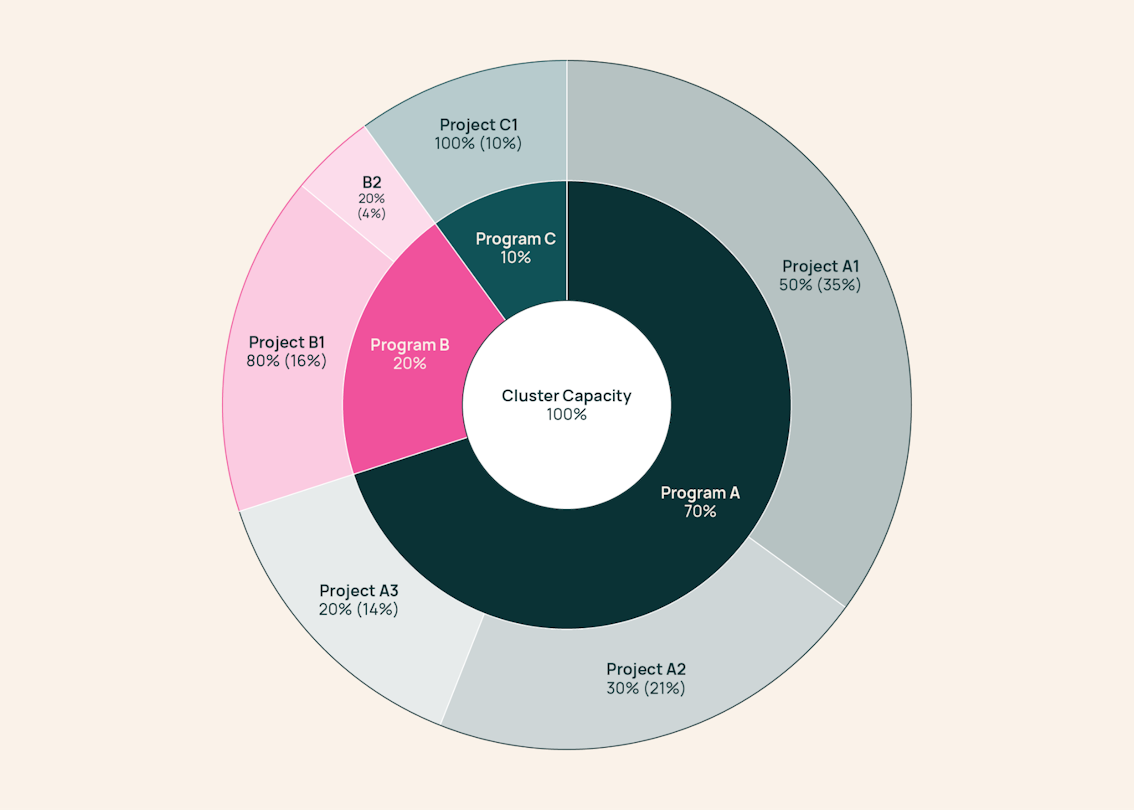
Значення в дужках позначають загальну потужність кластера, призначену кінцевому проєкту.
У цій системі кожен запит на час GPU має фінансуватися бюджетом, інакше він не захищений від переривання. У старій системі пріоритет HIGH нічого не коштував, а непереривність дозволяла команді необмежено заповнювати свій ліміт одночасних GPU, тому ними користувалися всі. Тепер безкоштовного нічого немає, тож будь-яка хитрість для отримання часу GPU витрачає кошти з розподілу користувача, який отримує вигоду. Робоче навантаження, що займає ресурси, витрачає бюджет команди на ніщо. Наша стратегія полягає в тому, щоб зробити маніпулювання планувальником дорожчим, ніж чесна участь в обговоренні більшого бюджету. Ми постійно вдосконалюємо цей процес перегляду бюджетів, але ключові вимоги полягають у тому, щоб дослідники часто мали можливість обґрунтовувати необхідний їм час, а рішення ухвалювали керівники, які найкраще розуміють відповідні компроміси. Це означає, що рішення щодо розподілу в межах дослідницького проєкту ухвалює провідний дослідник, у межах дослідницької програми — головний дослідник, а між програмами — головний менеджер програми або генеральний директор.
Чесна частка
Разом із цим інструментом бюджетування часу GPU ми створили ієрархічний планувальник із чесною часткою для керування фактичною зайнятістю розподілених ресурсів у всьому дереві програм. Алгоритм не є новим — ієрархічна чесна частка протягом часового вікна належить до напряму розробок, що бере початок із планувальника Hadoop Fair Scheduler 2009 року, а той самий підхід активно використовується сьогодні в Fair Tree у SLURM і Fair Scheduler у YARN. Новими для нас є вхідні дані: дерево відображає структуру дослідницьких програм, а ваги є бюджетами, встановленими керівниками, а не статичними квотами.
Планувальник відстежує зайнятість у ковзному вікні ретроспективного аналізу (за замовчуванням 7 днів) і розташовує робочі навантаження з недостатньо використаними розподілами вище за ті, що походять від надмірно використаних розподілів. Таким чином, протягом тижня ми можемо очікувати, що кожна група отримає виділений їй час GPU, якщо вона активно надсилає робочі навантаження з достатнім попитом.
«Новий планувальник створює відчуття, ніби ми отримали додаткові 30% обчислювальних ресурсів. У старому планувальнику, якщо часом нам не був потрібен увесь доступний ліміт, ці обчислення фактично втрачалися. Тепер, якщо так трапляється, ми пізніше можемо перевищити свій ліміт розподілу й усе одно бачити, що наші завдання швидко плануються без переривань, фактично повертаючи собі ці обчислювальні ресурси. Наші робочі навантаження часто мають піковий характер, тож це повернуло нам значний обсяг обчислень». — Кріс Кларк
Планувальник розрізняє два типи зайнятості. Розподілена зайнятість — це час, протягом якого робоче навантаження списується з бюджету. Він віднімається з розподілів власника робочого навантаження, впливає на розрахунок бюджету чесної частки, а ці робочі навантаження захищені від переривання протягом мінімального вікна виконання. Нерозподілена зайнятість не списується з жодного бюджету, від самого початку не захищена й може бути перервана будь-яким розподіленим запитом. Це дає змогу підтримувати повну зайнятість GPU, навіть коли розподіли не відповідають попиту, і не дозволяє командам відмовлятися від безкоштовних циклів GPU.
Контракт на планування
Ще одна особливість розподіленого навчання, яка ускладнює справедливий розподіл ресурсів, полягає в тому, що робочі навантаження можуть виконуватися дуже довго. Завдання навчання регулярно тривають години, дні, а іноді й тижні. Після планування робоче навантаження могло залишатися на призначених GPU тиждень або довше, не даючи іншим можливості отримати передбачений бюджетом час. Саме ця властивість системи зробила можливою «окупацію» GPU. Вона ж змушувала чергових інженерів домовлятися з власниками довготривалих завдань для вирішення поточних проблем обслуговування.
Щоб розв’язати ці проблеми, ми запровадили «контракт на планування». В обмін на доступ до кластера робоче навантаження має оголосити мінімальний час виконання — найкоротший період зайнятості, необхідний для значущого прогресу. Протягом цього часу робоче навантаження захищене від переривання. Це гарантує досліднику прогрес і водночас надає планувальнику право перебалансувати ресурси після накопичення цього прогресу, автоматично повторно ставлячи в чергу робочі навантаження, які можна відновити. Як альтернатива, користувач може встановити мінімальний час виконання на нуль, що означає, що час GPU має бути нерозподіленим. Такі робочі навантаження завжди можуть бути перервані, але вони також безкоштовні в тому сенсі, що не списуються з жодного бюджету.
Життєвий цикл робочого навантаження має такий вигляд:
- Робоче навантаження надсилається із зазначенням мінімального часу виконання та інформації про те, чи можна його відновити.
- Робоче навантаження планується відповідно до алгоритму чесної частки, зваженого за співвідношенням фактичної зайнятості до розподіленого часу у вікні ретроспективного аналізу.
- Робоче навантаження виконується протягом мінімального часу, який списується з його розподілів.
- Робоче навантаження може продовжувати виконуватися, доки пов’язані розподіли продовжують надавати йому пріоритет над іншими. Цей час також списується з його розподілів.
- Його можна перервати й повторно поставити в чергу, що повертає процес до кроку 2.
- Робоче навантаження завершується, звільняючи заявлені ним ресурси.
Разом ці угоди додають до нашого планувальника розподіл часу. Робочі навантаження, що виконуються, можуть автоматично вилучатися й повторно ставитися в чергу, даючи змогу чесній частці зближуватися з цільовими значеннями та зменшуючи стимули до «окупації». Вони також дають змогу хостам із несправностями вивільняти свої робочі навантаження після досягнення ними мінімального часу виконання, завдяки чому ремонтні операції можна повністю автоматизувати. Цей останній момент виявився важливішим, ніж ми усвідомлювали під час планування роботи. Він на 74% зменшив кількість ремонтів, що потребували участі людини, — це суттєво скоротило навантаження на чергових інженерів.
Симуляції
Ми знаємо, що зміни політики планування можуть мати непередбачені наслідки. Нульова сума цієї проблеми означає, що надання часу одному досліднику означає його вилучення в іншого. Користувачі, які програють у цьому обміні, зазвичай шукають нові обхідні шляхи. Перед розгортанням системи на основі бюджетів ми хотіли отримати швидкий спосіб передбачити, де можуть виникнути довші черги, і перевірити параметри конфігурації, як-от тривалість вікна ретроспективного аналізу або максимальне значення мінімального часу виконання (ми обрали 8 годин).
Ми створили невелике середовище симуляції, яке приймає як вхідні дані набір робочих навантажень і розклад їх надсилання та дає планувальнику змогу ухвалювати рішення про переривання й призначення GPU. Знаючи запитану кількість GPU і загальну тривалість кожного робочого навантаження, симулятор міг переходити до моментів, коли можливе планування, і за кілька секунд надавати аналіз часу очікування в черзі, подій переривання та розподілу часу GPU між проєктами за багато змодельованих днів. Ми запускали симулятор як на історичних даних надсилання, так і на створених сценаріях, які хотіли краще зрозуміти.
Однією з гіпотез, яку ми хотіли перевірити, були «налагоджувальні робочі навантаження». Ці завдання потребують невеликої кількості GPU та мінімального часу виконання 15 хвилин або менше — цього достатньо, щоб користувач зрозумів, чи запускається завдання успішно, чи аварійно завершується через помилку або неправильну конфігурацію. Ми хотіли дізнатися, чи матимуть ці завдання менший час очікування в черзі, ніж великі робочі навантаження навчання, яким часто потрібно багато GPU і годин виконання для досягнення значущого прогресу. Інтуїтивно такі менші завдання мали б підніматися на вершину черги, оскільки мале завдання може розміститися в більшій кількості місць, ніж велике. Але важлива була точна затримка в черзі. Коротке очікування в одну-дві хвилини відкрило б нову практику розробки, тоді як очікування десять хвилин стало б неприйнятним.
Для наших симуляцій були потрібні вручну створені тестові дані, оскільки в історичних записах не було достатньо великої кількості таких налагоджувальних робочих навантажень. Результати підтвердили гіпотезу: час очікування налагоджувальних робочих навантажень на рівні p90 скоротився приблизно з 6 годин до лише 5 хвилин.
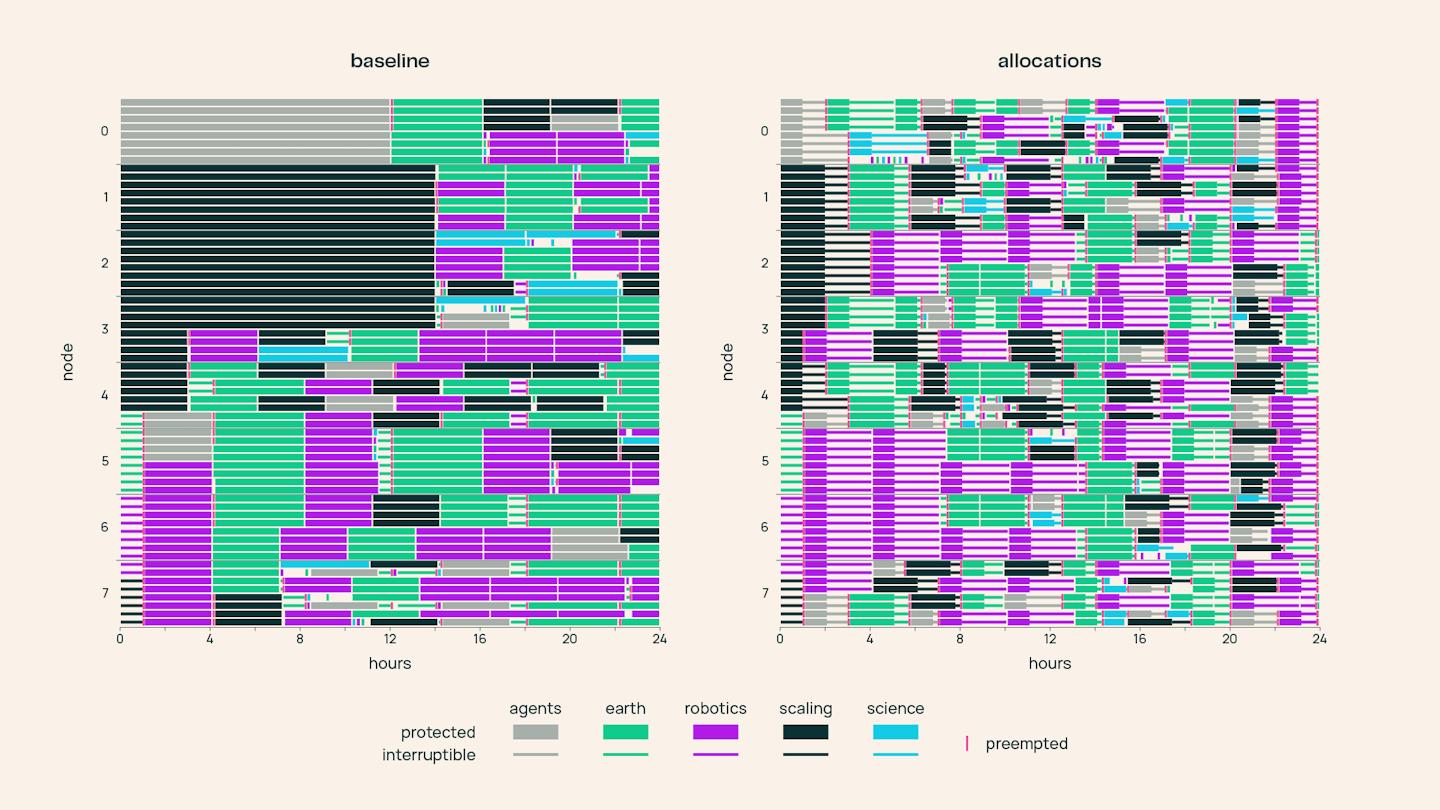
Візуалізація симулятора в меншому масштабі для базового планувальника (ліворуч) і нового планувальника «розподілів» (праворуч). Кожен рядок відповідає одному GPU; кожна смуга — завданню, забарвленому відповідно до батьківського робочого навантаження, з одним відтінком кольору для кожної команди; штрихування позначає час, коли завдання можна перервати, а червоний край — переривання. У базовому планувальнику довгі термінові завдання ніколи не перериваються, а для роботи з нижчими рівнями пріоритету відбувається менше переривань. Новий планувальник має більшу суміш кольорів на кожному GPU, що ілюструє ротацію зайнятості між командами.
Результати
Маючи результати симуляцій, наприкінці липня ми почали поетапне розгортання в окремих кластерах. Нас цікавило, чи отримали профінансовані нами робочі навантаження передбачений їм час, чи підтримувала нова система повну зайнятість і чи могли дослідники зрозуміти роботу планувальника, щоб ухвалювати обґрунтовані рішення.
Після розгортання ми спостерігали, що користувачі й команди стабільно отримують виділений їм час GPU. Ми рахуємо час, належний команді, як її розподіл, обмежений щогодини фактичним попитом. За 30-денний тестовий період команди отримали 98% належних їм годин GPU, а 13 із 15 розподілів команд отримали 95% або більше; найгірший результат становив 90%. Зайнятість кластера залишалася на рівні 98% до і після змін, а попит в обох періодах перевищував потужність у 2–3 рази. 18% наданого часу GPU були нерозподіленими, завдяки чому ми підтримували високу зайнятість у періоди, коли профінансовані сценарії використання не були готові до запуску.
Результати симулятора виявилися правильними за напрямом, а реальні результати перевершили наші прогнози. Час очікування в черзі для налагоджувальних робочих навантажень на рівні p90 скоротився з 2 годин до 30 секунд у новому планувальнику, тоді як симуляція прогнозувала скорочення з 6 годин до 5 хвилин на основі вручну створених тестових сценаріїв. Варто зазначити, що менший обсяг вибірки налагоджувальних робочих навантажень у базовому режимі означав вищу варіативність цих вимірювань. Загальна затримка в черзі також покращилася як побічний ефект розподілу часу: у нашому найбільшому кластері H100 медіанний час очікування в черзі скоротився з 5 хвилин до 24 секунд, а час очікування на рівні p90 — приблизно на третину (з 2,8 години до 1,8 години).
Порівняно з трьома проблемами, які ми прагнули розв’язати:
«Окупація» ресурсів: Короткі налагоджувальні робочі навантаження запускаються менш ніж за хвилину, що зменшує цінність «окупації». Вартість такої поведінки списується з бюджету того, хто займає ресурси, і не дозволяє йому отримати час, коли він справді його потребує.
Інфляція пріоритетів: Ми й надалі дозволяємо робочим навантаженням оголошувати пріоритет, але він впливає лише на сортування в межах команди. Керівники мають стимул контролювати пріоритети в усій групі, щоб оптимізувати використання своїх бюджетів.
Навантаження на чергових інженерів: Несправні хости автоматично вивільняються, коли робочі навантаження досягають мінімального часу виконання. Кількість ремонтів, що потребують участі людини, скоротилася на 74%.
Виклики
Крива навчання виявилася крутішою, ніж ми припускали. Ми впроваджували зміни поступово, тому на перших етапах дослідники стикалися з різною поведінкою залежно від того, який кластер вони обирали. Крім того, у наших інтерфейсах збереглися деякі старі терміни (наприклад, пріоритет робочого навантаження), значення яких змінилися. Однієї документації було недостатньо, щоб усунути плутанину. Натомість ефективними виявилися живі пояснювальні сесії, під час яких дослідники могли ставити запитання, а інженерна команда — детальніше пояснювати як те, так і те, чому планувальник ухвалював рішення щодо пріоритетів, використовуючи реальні приклади.
Це був ключовий момент, оскільки він ознаменував перехід від раннього періоду розчарувань і непідтверджених теорій до нинішнього режиму, у якому дослідницькі групи частіше й ширше обговорюють потреби своїх експериментів у GPU. Тепер дослідники беруть участь в обговоренні бюджетів, краще розуміючи компроміси, на які доводиться йти для задоволення кожного нового запиту.
На додаток до очних сесій після запуску ми запровадили нові візуалізації, щоб користувачі краще розуміли, наскільки призначений їм час GPU відповідає очікуваним розподілам, а також безпосередньо бачили метрику, що використовується для сортування черги робочих навантажень. Це створило просте місце для перевірки, коли робоче навантаження переривалося, щоб зрозуміти причину. Ці візуалізації також допомогли власникам бюджетів, які могли бачити, як час GPU використовується в різних проєктах під їхнім керуванням.
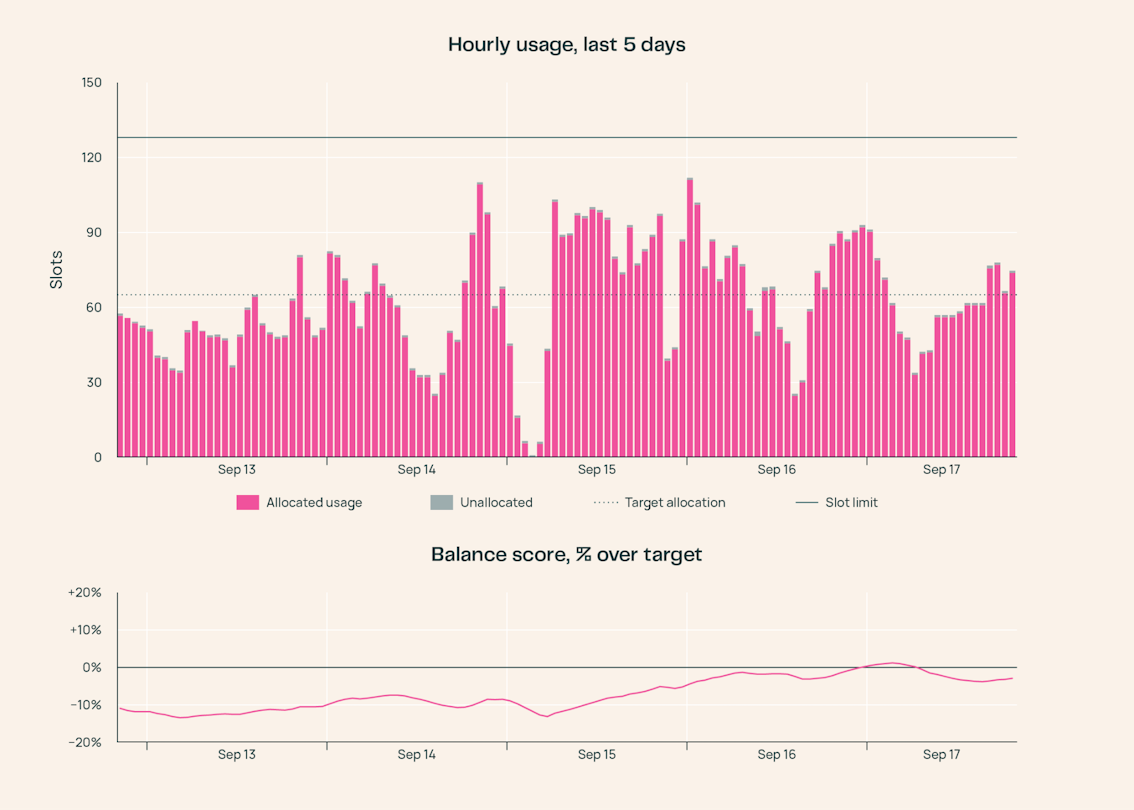
Приклад візуалізації використання розподілу з часом.
Не кожен сценарій використання покращився. Окрім розподіленого навчання, наші дослідники запускають інтерактивні сесії, під час яких аналізують дані та тестують код навчання в процесі його написання. У старій системі дослідник міг утримувати таку сесію до тижня. За розподілу часу на них поширювався 8-годинний ліміт захищеного виконання, після чого сесія ставала переривною, якщо перевищувала свій розподіл. Ми не усвідомлювали, наскільки дослідники залежали від нестабільного стану цих сесій. Переривання означало очікування на отримання нової сесії, а також ручне відновлення її стану. Після опитування дослідників, щоб зрозуміти масштаб проблеми, ми створили два нові проєкти в дорожній карті. Ми інвестуємо в кластер лише з CPU поруч із нашим локальним сховищем для сесій розробки, зосереджених на підготовці даних. Це збереже потужність нашого навчального кластера для робочих навантажень, яким вона справді потрібна. Крім того, ми плануємо створити сесії, які можна відновлювати, для цих робочих навантажень лише на CPU. Це дасть нам змогу й надалі переривати робочі навантаження після завершення мінімального часу виконання для обслуговування або розподілу часу, водночас відновлюючи сесію в іншому місці без необхідності повторної ручної роботи дослідника. Ми зможемо зберегти операційні переваги й переваги планування нової системи, одночасно покращивши взаємодію з користувачами.
Ми продовжуємо стежити за новими проблемами. Одна з потенційних проблем, яку ми досліджуємо, — фрагментація потужності, що може призвести до збільшення часу очікування в черзі для найбільших робочих навантажень. На нашу думку, захист мінімального часу виконання застосовується до типів завдань, які раніше покладалися на механізми, що допускають переривання, щоб перевищувати ліміт одночасних GPU команди. Раніше ці завдання можна було перервати в будь-який момент, що потенційно марнувало цей час, але водночас полегшувало планування великих завдань. Тепер планувальник може мати менше можливостей одночасно перервати багато завдань, щоб розмістити велике робоче навантаження, що очікує. Наразі ми використовуємо інструменти симулятора для відтворення цієї проблеми, одночасно вимірюючи фактичні дані у виробничій системі.
Майбутнє
Дивлячись за межі описаної тут роботи над плануванням, ми прагнемо до вершини піраміди — використання. Нам потрібно забезпечити максимально ефективне виконання початкового запуску, створення контрольних точок і самих застосунків навчання, щоб максимізувати цінність запланованого часу, який отримує кожне робоче навантаження.
Якщо ви хочете розв’язувати подібні завдання у тісній співпраці з дослідниками, ми запрошуємо вас ознайомитися з відкритими інженерними вакансіями в Ai2.


Спільнота
· Зареєструйтеся або увійдіть, щоб прокоментувати
Перекладено автоматично з англійської. Оригінал статті — за посиланням нижче.