Эффективное планирование для GPU-кластеров



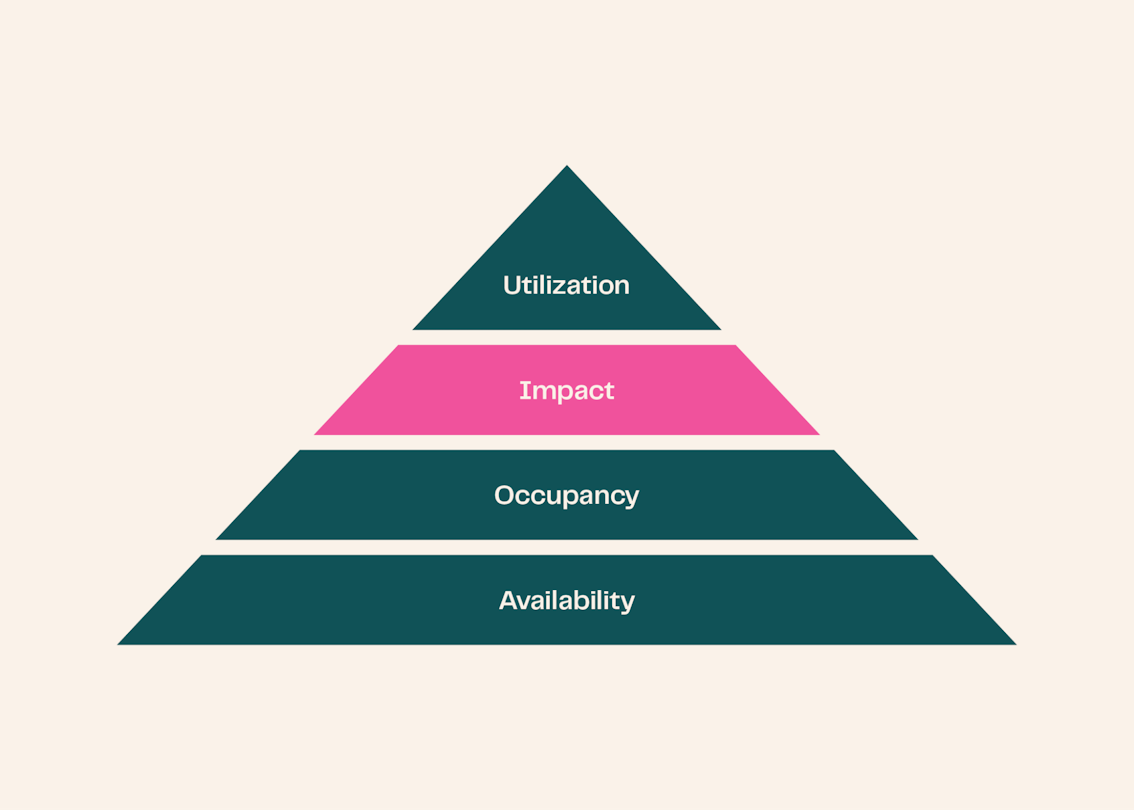
В команде AI-инфраструктуры Ai2 мы отвечаем за обеспечение института вычислительными мощностями GPU, в частности для крупных распределённых задач обучения. Мы рассматриваем эту задачу как пирамиду из четырёх взаимосвязанных метрик.
В основании лежит доступность: насколько часто оборудование исправно и готово к работе. Выше находится загрузка: доля доступного времени, назначенного конкретной задаче. Далее идёт значимость: насколько часто наиболее ценные задачи выбираются для получения ресурсов. Венчает пирамиду использование: доля GPU-мощностей, использованная за всё время работы задачи.
В этой статье рассказывается об улучшении значимости наших решений по планированию. Недавно мы заменили планировщик на основе приоритетов системой, включающей бюджеты времени GPU, иерархическое распределение по принципу справедливой доли и контракт на выделение временных интервалов. В результате обсуждение того, сколько времени GPU заслуживает каждый исследовательский проект, перешло от операционной задачи, решаемой в каждом отдельном случае, к прозрачному административному процессу бюджетирования.
Перераспределение ресурсов
В Ai2 мы управляем тысячами GPU NVIDIA H100, B200 и B300, объединёнными в кластеры размером от 88 до 1024 GPU. Эти кластеры предназначены для крупномасштабного распределённого обучения ИИ-моделей и обслуживают около 150 внутренних исследователей, работающих в различных областях ИИ, включая полный цикл обучения LLM и VLM, симуляции обучения с подкреплением (RL) для робототехники и дообучение для научных агентных сценариев.
Как и многие лаборатории, мы сталкиваемся со спросом на время GPU, значительно превышающим предложение. Судя по отправленным задачам, в любой момент у нас есть невыполненные запросы на объём GPU, в 2–3 раза превышающий доступный. Иными словами, за каждый доступный час работы GPU в нашем кластере конкурируют 2–3 различные исследовательские задачи.
Исторически мы использовали планировщик на основе приоритетов и разрешали задачам отказываться от возможности вытеснения. Каждая команда имела ограничение на число одновременно используемых GPU для задач, защищённых от вытеснения. Задачи, допускающие вытеснение, могли превышать этот лимит на простаивающих GPU. Такая стратегия приводила к предсказуемым проблемам. Например, мы наблюдали случаи «захвата» GPU, когда пользователи размещали задачи без операций, к которым можно было подключиться при возникновении необходимости. Это происходило потому, что исследователи не могли запускать отладочные задачи с достаточно малой задержкой, чтобы решать проблемы в реальном времени. Мы также наблюдали инфляцию приоритетов: со временем все 100% запланированных задач имели приоритет HIGH. Это полностью лишало задачи с более низкими приоритетами времени GPU. Поскольку возможность вытеснения была необязательной, наши дежурные инженеры также тратили большую часть времени на обработку заявок на согласование организованной остановки невытесняемых задач, работавших на узлах с известными проблемами обслуживания.
Трагедия общих ресурсов
Когда появились эти проблемы, мы не сразу выявили их коренные причины. Первые попытки обеспечить наиболее важные задачи временем GPU были сосредоточены на более жёстком контроле назначения приоритетов и, в конечном счёте, на обходе планировщика на основе приоритетов путём явного предоставления важным проектам монопольного доступа к GPU. Хотя поначалу мы этого не осознавали, мы создали идеальную лабораторию для наблюдения за «трагедией общих ресурсов». Люди конкурировали за редкий общий ресурс и, стремясь максимизировать индивидуальные результаты, достигали неоптимального глобального результата и злоупотребляли базовым ресурсом.
Мы были далеко не первыми, кто столкнулся с подобным взаимодействием. Распределение ресурсов — увлекательная исследовательская область, объединяющая разработку алгоритмов, экономику и управление системами. Основная проблема заключается в том, что пользователи часто лучше организации знают ценность собственных задач, но могут быть заинтересованы в сокрытии этой ценности или удержании ресурсов, даже когда это вредит общей производительности. Например, в статье 2011 года, посвящённой представлению метода Dominant Resource Fairness, Годси и соавторы рассказывают историю о том, как поисковая компания предоставляла задачам выделенные машины только в том случае, если их пользователи могли гарантировать высокую загрузку. Вскоре выяснилось, что «пользователи добавляли в свой код бесконечные циклы, чтобы искусственно завысить показатели загрузки». Оборудование меняется, но фундаментальные проблемы, усложняющие распределение ресурсов, сохраняются.
Бюджеты, а не расписания
Классическое решение проблемы общих ресурсов — приватизировать общий ресурс: владельцы получают стимул максимизировать ценность своей собственности. Когда мы предоставляли командам монопольный доступ к наборам GPU, мы уже частично реализовывали этот подход, но он был слишком грубым. Из-за сезонности исследований GPU простаивали. Команды готовы запускать эксперименты и обучение в разное время, поэтому предоставление монополии неизбежно приводило бы к периодам, когда не было готовых к выполнению задач, а другая команда в это время ждала бы доступных мощностей.
Мы вручную решали задачу о рюкзаке, пытаясь вписать динамически меняющиеся исследовательские потребности в статическое расписание. Мы хотели сохранить стимул владельца, но одновременно поддерживать полную загрузку GPU.
Мы решили доработать модель владения. Вместо предоставления командам GPU мы выбрали распределение доли времени GPU. Прогнозирование будущего спроса потребовало бы знания результатов новых научных экспериментов, поэтому точно предсказать его невозможно. Приоритет исследовательских направлений, однако, является стратегическим вопросом, который проще обсуждать и решать заранее. Вместо попытки решить головоломку планирования мы позволили руководству мыслить как инвесторы. Ещё до появления задач следует решить, сколько времени GPU выделить каждому исследовательскому направлению, основываясь на оценке его вероятного влияния. После этого планировщик мог использовать эту информацию при расстановке приоритетов прибывающих задач.
С учётом этого мы разработали иерархическую систему, в которой руководители могли пропорционально распределять время GPU между проектами и исследователями, за которых они отвечали. Как показано на схеме ниже, это напрямую переводит стратегию программы в гарантированную долю времени GPU. Проект A1 знает, что ему принадлежит 35% общей мощности, независимо от того, сколько других проектов выстроилось в очередь в других местах.
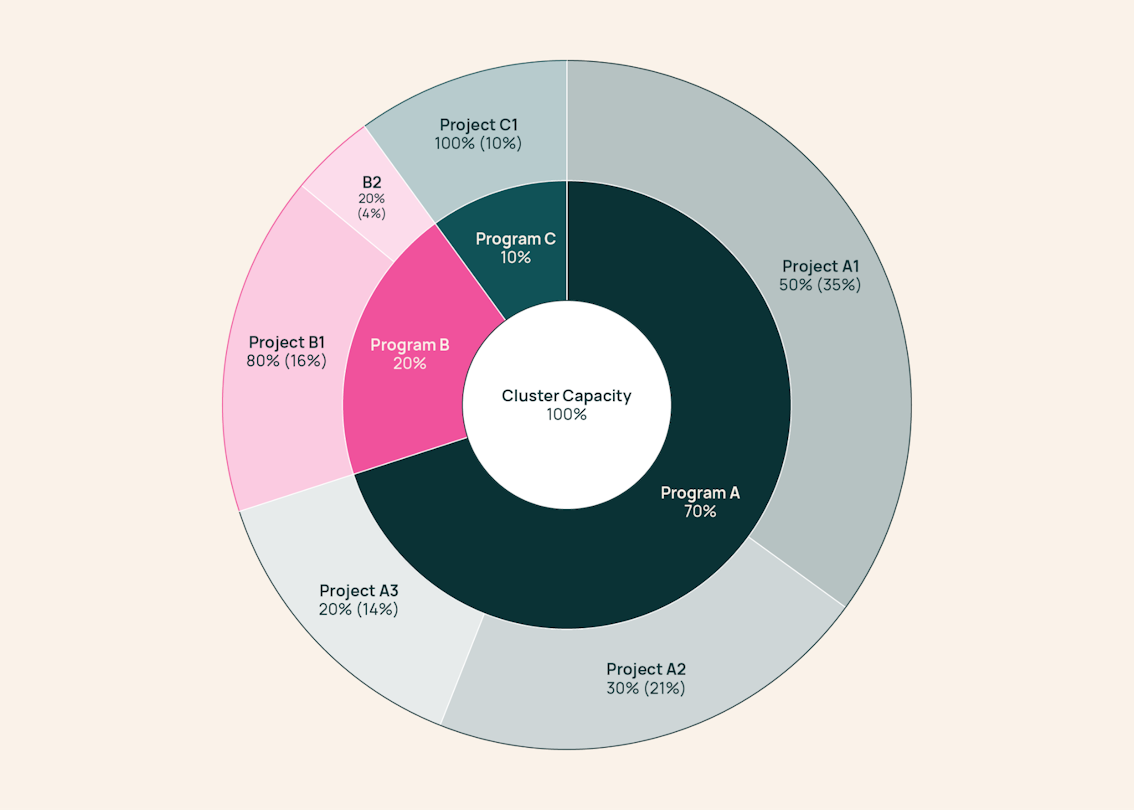
Значения в скобках обозначают общий объём мощности кластера, назначенный конечному проекту.
В этой системе каждый запрос на время GPU должен финансироваться из бюджета, иначе он не защищён от вытеснения. В старой системе высокий приоритет ничего не стоил, а невозможность вытеснения позволяла команде бесконечно заполнять свой лимит одновременно используемых GPU, поэтому этими возможностями пользовались все. Теперь ничего не предоставляется бесплатно, поэтому любая уловка для получения времени GPU расходует средства выделения пользователя, которому это выгодно. Задача, удерживающая GPU без работы, тратит командный бюджет впустую. Наша стратегия заключается в том, чтобы сделать эксплуатацию планировщика более дорогой, чем честное участие в обсуждении увеличения бюджета. Мы постоянно совершенствуем процесс пересмотра бюджетов, но ключевые требования таковы: исследователи должны часто получать возможность обосновать необходимое им время, а решения должны принимать руководители, лучше всего понимающие соответствующие компромиссы. Это означает, что решения о распределении внутри исследовательского проекта принимает ведущий исследователь, внутри исследовательской программы — главный исследователь, а между программами — руководитель программы или генеральный директор.
Справедливое распределение
Вместе с инструментом бюджетирования времени GPU мы создали иерархический планировщик справедливой доли для управления фактической загрузкой выделенных ресурсов по всему дереву программ. Сам алгоритм не нов: иерархическое справедливое распределение по временному окну восходит к планировщику Hadoop Fair Scheduler 2009 года, а сегодня тот же подход активно используется в Fair Tree в SLURM и Fair Scheduler в YARN. Новыми для нас являются входные данные: дерево отражает структуру исследовательских программ, а веса представляют собой бюджеты, установленные руководителями, а не статические квоты.
Планировщик отслеживает загрузку за скользящее окно ретроспективного анализа (по умолчанию 7 дней) и располагает задачи с недостаточно используемыми выделениями выше задач с чрезмерно используемыми выделениями. Таким образом, за недельный период мы можем ожидать, что каждая группа получит выделенное ей время GPU, если она активно отправляет задачи с достаточным спросом.
«Новый планировщик создаёт ощущение, будто у нас появилось ещё 30% вычислительных ресурсов. В старом планировщике, если иногда нам не требовался весь выделенный лимит, эти ресурсы фактически терялись. Теперь, если такое происходит, мы можем позднее превысить свой лимит выделения и при этом быстро запланировать задачи без вытеснения — фактически вернуть себе эти вычислительные ресурсы. Наши задачи часто запускаются неравномерно, поэтому мы вернули значительный объём вычислительных мощностей». — Chris Clark
Планировщик различает два вида загрузки. Выделенная загрузка — это время, в течение которого задача учитывается в бюджете. Оно вычитается из выделений владельца задачи, влияет на расчёт бюджета справедливой доли, а такие задачи защищены от вытеснения в течение минимального окна выполнения. Нераспределённая загрузка не списывается ни с какого бюджета, с самого начала не защищена и может быть вытеснена любым выделенным запросом. Это позволяет поддерживать полную загрузку GPU, даже когда выделения не соответствуют спросу, и не даёт командам отказываться от бесплатных циклов GPU.
Контракт планирования
Дополнительная особенность распределённого обучения, усложняющая справедливое распределение ресурсов, заключается в том, что задачи могут выполняться очень долго. Задачи обучения регулярно работают часами, днями, а иногда и неделями. После планирования задача могла оставаться на назначенных ей GPU неделю или дольше, не оставляя другим возможности получить выделенное им время. Именно это свойство системы сделало возможным захват GPU. Оно же вынуждало дежурных инженеров договариваться с владельцами длительных задач для решения текущих проблем обслуживания.
Для решения этих проблем мы ввели «контракт планирования». В обмен на доступ к кластеру задача должна объявить минимальное время выполнения — наименьшую продолжительность загрузки, необходимую для достижения значимого прогресса. В течение этого времени задача защищена от вытеснения. Это даёт исследователю гарантию прогресса, а планировщику — право перераспределить ресурсы после накопления этого прогресса, автоматически возвращая возобновляемые задачи в очередь. Кроме того, пользователь может установить минимальное время выполнения равным нулю, что означает, что время GPU должно быть нераспределённым. Такие задачи всегда могут быть вытеснены, но в определённом смысле они бесплатны, поскольку не списываются ни с какого бюджета.
Жизненный цикл задачи выглядит следующим образом:
- Задача отправляется с минимальным временем выполнения и указанием, может ли она быть возобновлена.
- Задача планируется в соответствии с алгоритмом справедливой доли, взвешенным отношением фактической загрузки к выделенному времени в окне ретроспективного анализа.
- Задача выполняется в течение минимального времени, которое списывается с её выделений.
- Задача может продолжать выполняться, пока связанные с ней выделения по-прежнему обеспечивают ей приоритет перед другими задачами. Это время также списывается с её выделений.
- Задача может быть вытеснена и повторно поставлена в очередь, после чего процесс возвращается к шагу 2.
- Задача завершается, освобождая принадлежащие ей ресурсы.
В совокупности эти соглашения добавляют в наш планировщик распределение времени. Выполняющиеся задачи могут автоматически удаляться и возвращаться в очередь, позволяя справедливой доле сходиться к равновесию и снижая стимулы к захвату ресурсов. Они также позволяют разгружать нездоровые узлы по достижении задачами минимального времени выполнения, благодаря чему операции восстановления можно полностью автоматизировать. Последний момент оказался важнее, чем мы предполагали при планировании этой работы. Количество восстановительных операций, требующих участия человека, сократилось на 74%, что значительно снизило нагрузку на дежурных инженеров.
Симуляции
Мы знаем, что изменения политики планирования могут иметь непредвиденные последствия. Нулевая сумма этой задачи означает, что предоставление времени одному исследователю лишает его другого. Пользователи, проигравшие в таком обмене, обычно ищут новые обходные пути. До внедрения системы на основе бюджетов мы хотели получить быстрый способ предсказывать, где могут возникнуть более длительные ожидания, и проверять параметры конфигурации, например длину окна ретроспективного анализа или максимальное значение минимального времени выполнения (мы выбрали 8 часов).
Мы создали небольшую среду симуляции, которая принимает на вход набор задач и расписание их отправки и позволяет планировщику принимать решения о вытеснении и назначении GPU. Зная запрошенное каждой задачей количество GPU и общее время выполнения, симулятор мог перемещаться к ближайшим моментам, когда возможно планирование, и за несколько секунд предоставлять анализ времени ожидания в очереди, событий вытеснения и распределения времени GPU между проектами за множество смоделированных дней. Мы запускали симулятор как на исторических данных об отправке задач, так и на созданных сценариях, которые хотели лучше понять.
Одной из проверяемых гипотез были «отладочные задачи». Для них требуется небольшое количество GPU и минимальное время выполнения не более 15 минут — этого достаточно, чтобы пользователь понял, успешно ли запускается задача или она сразу завершается из-за ошибки либо неправильной конфигурации. Мы хотели выяснить, будет ли время ожидания таких задач в очереди меньше, чем у крупных задач обучения, которым часто требуется много GPU и несколько часов для достижения значимого прогресса. Интуитивно такие небольшие задачи должны подниматься в начало очереди, поскольку небольшая задача может разместиться в большем числе мест, чем крупная. Но точная задержка в очереди имела значение. Короткое ожидание в одну-две минуты открыло бы новую практику разработки, тогда как ожидание в десять минут сделало бы её невозможной.
Для наших симуляций потребовались тестовые данные, созданные вручную, поскольку в исторических записях не было достаточного количества задач, похожих на отладочные. Результаты подтвердили гипотезу: время ожидания отладочных задач на уровне p90 сократилось примерно с 6 часов до всего 5 минут.
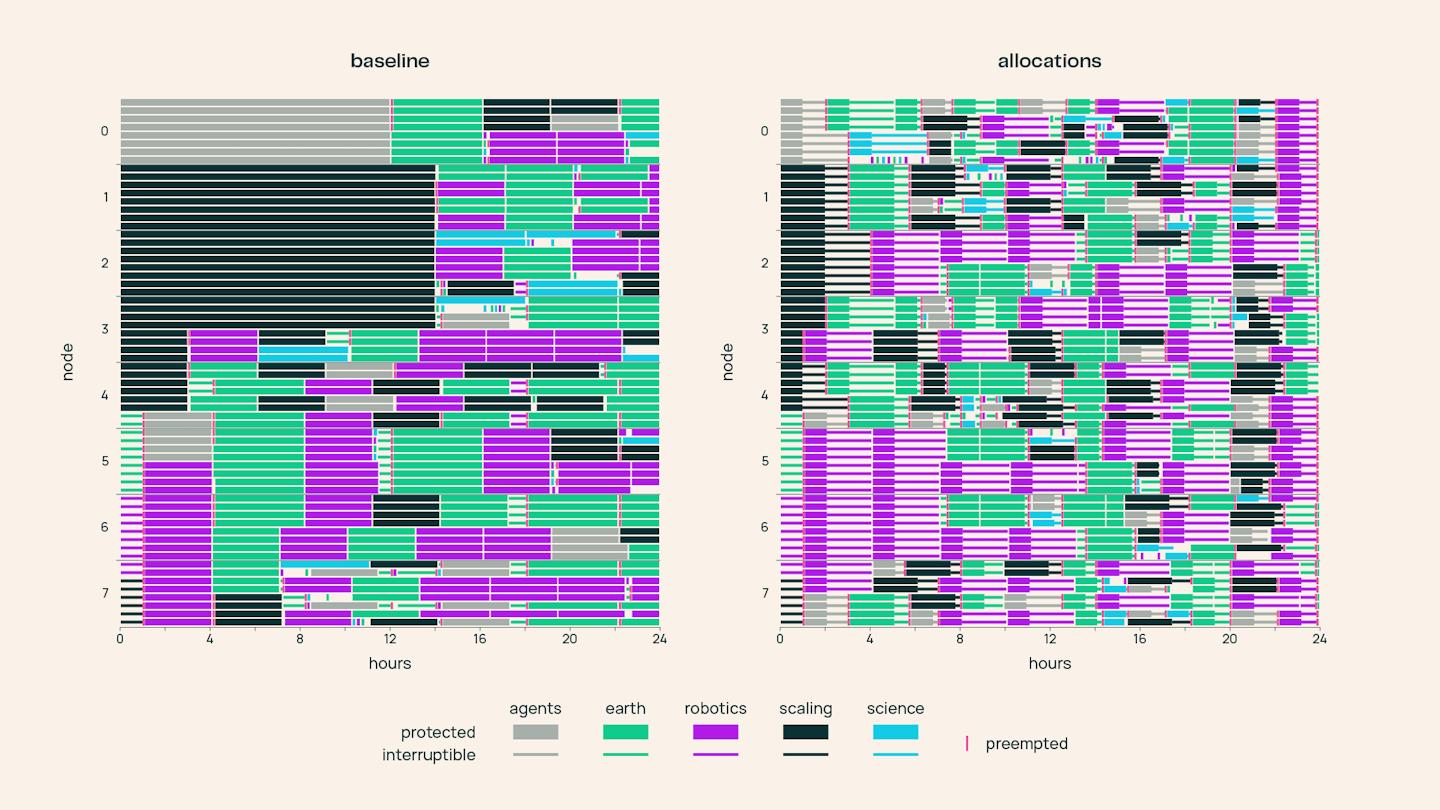
Визуализация симулятора в меньшем масштабе для базового планировщика (слева) и нового планировщика «выделений» (справа). Каждая строка представляет один GPU; каждая полоса — задачу, окрашенную в цвет родительской задачи, с отдельным оттенком для каждой команды; штриховка обозначает время, когда задачу можно прервать, а красная граница — вытеснение. В базовом планировщике длительные срочные задачи никогда не прерываются, а для задач с более низкими уровнями приоритета происходит меньше вытеснений. Новый планировщик демонстрирует большее разнообразие цветов на каждом GPU, показывая ротацию загрузки между командами.
Результаты
Получив результаты симуляций, в конце июля мы начали поэтапное внедрение системы для каждого кластера. Нас интересовало, получили ли профинансированные нами задачи выделенное им время, сохранила ли новая система полную загрузку и могли ли исследователи понимать работу планировщика, чтобы принимать обоснованные решения.
После внедрения мы наблюдали, что пользователи и команды стабильно получают выделенное им время GPU. Время, причитающееся команде, мы рассчитываем как её выделение, ограниченное фактическим спросом, по каждому часу. За 30-дневный тестовый период команды получили 98% причитающихся им часов GPU, а 13 из 15 выделений команд достигли 95% или более; худший результат составил 90%. Загрузка кластера оставалась на уровне 98% до и после изменения, при этом в оба периода спрос превышал мощности в 2–3 раза. 18% предоставленного времени GPU было нераспределённым — именно это позволило сохранить высокую загрузку в периоды, когда профинансированные сценарии использования ещё не были готовы к запуску.
Результаты симулятора оказались верны по направлению, а реальные показатели превзошли прогнозы. Время ожидания отладочных задач в очереди на уровне p90 сократилось с 2 часов до 30 секунд при новом планировщике, тогда как симуляция на основе вручную созданных сценариев предсказывала сокращение с 6 часов до 5 минут. Стоит отметить, что меньший объём отладочных задач в базовом варианте означал более высокую вариативность этих измерений. В целом задержка в очереди также улучшилась благодаря распределению времени: в нашем крупнейшем кластере H100 медианное время ожидания в очереди сократилось с 5 минут до 24 секунд, а время ожидания на уровне p90 — примерно на треть, с 2,8 часа до 1,8 часа.
Если сравнить результаты с тремя проблемами, которые мы намеревались решить:
Захват ресурсов: короткие отладочные задачи запускаются менее чем за минуту, что снижает ценность захвата GPU. Стоимость такого поведения списывается с бюджета захватившего ресурс пользователя, не позволяя ему получить время, когда оно действительно понадобится.
Инфляция приоритетов: мы по-прежнему разрешаем задачам указывать приоритет, но он влияет только на сортировку внутри команды. Руководители заинтересованы в мониторинге приоритетов всей группы для оптимизации использования своих бюджетов.
Нагрузка на дежурных: нездоровые узлы автоматически разгружаются, когда задачи достигают минимального времени выполнения. Количество восстановительных операций, требующих участия человека, сократилось на 74%.
Проблемы
Кривая обучения оказалась более крутой, чем мы предполагали. Мы внедряли изменение постепенно, поэтому на ранних этапах исследователи сталкивались с разным поведением в зависимости от выбранного кластера. Кроме того, наши интерфейсы сохранили некоторые старые термины (например, приоритет задачи), значение которых изменилось. Одной документации оказалось недостаточно для устранения путаницы. Эффективными стали живые разъяснительные сессии, где исследователи могли задавать вопросы, а инженерная команда — подробно объяснять, как и почему планировщик принимает решения о приоритетах, используя реальные примеры.
Это был важный момент, поскольку он обозначил переход от раннего периода разочарований и неформальных теорий к текущему режиму, в котором исследовательские группы чаще и шире обсуждают потребности своих экспериментов в GPU. Теперь исследователи участвуют в обсуждении бюджетов, лучше понимая компромиссы, необходимые для удовлетворения каждого нового запроса.
Помимо очных сессий, после запуска мы добавили новые визуализации, чтобы пользователи лучше понимали, насколько назначенное им время GPU соответствует ожидаемым выделениям, а также напрямую видели метрику, используемую для сортировки очереди задач. Это стало удобным местом для выяснения причин вытеснения задачи. Визуализации также помогли владельцам бюджетов: они могли видеть, как время GPU используется в различных проектах под их управлением.
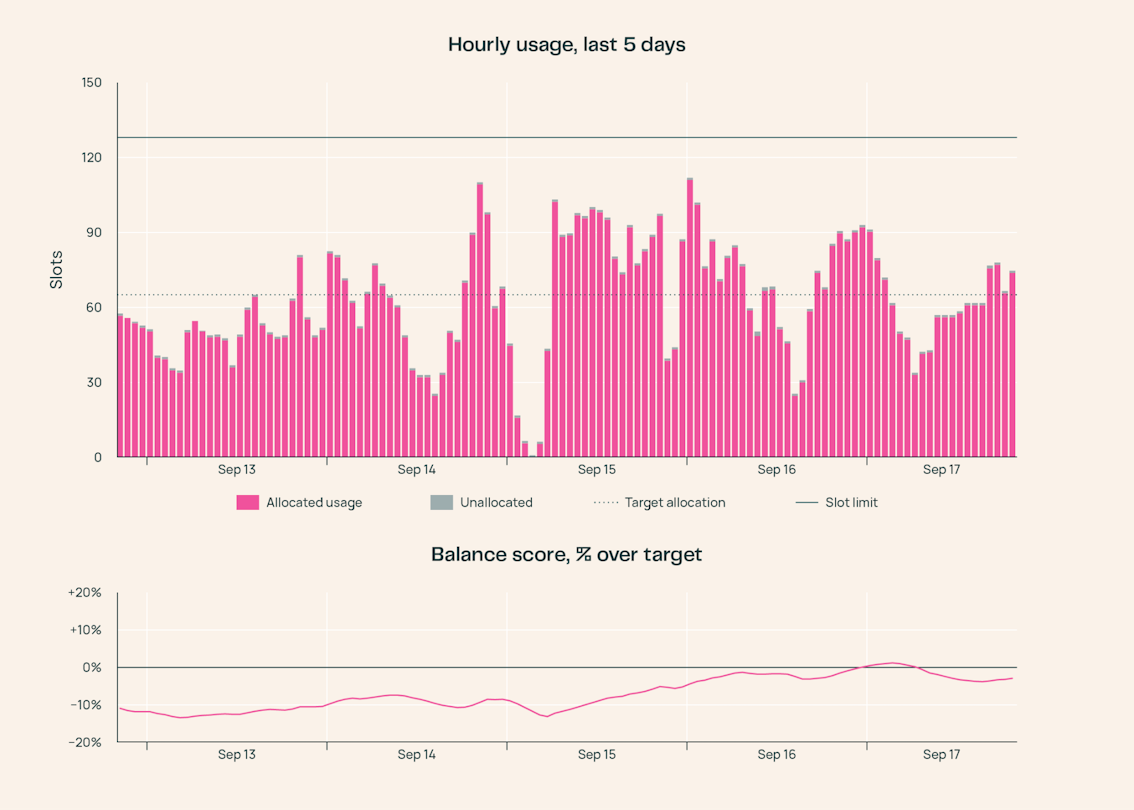
Пример визуализации использования выделений во времени.
Не все сценарии использования улучшились. Помимо распределённого обучения, наши исследователи запускают интерактивные сессии, в которых анализируют данные и тестируют код обучения по мере его написания. В старой системе исследователь мог удерживать такую сессию до недели. При распределении времени на неё распространялся 8-часовой лимит защищённого времени выполнения, после чего сессия становилась доступной для вытеснения, если превышала своё выделение. Мы недооценивали степень зависимости исследователей от изменчивого состояния этих сессий. Вытеснение означало необходимость ждать получения новой сессии, а также вручную восстанавливать её состояние. После опроса исследователей для оценки масштаба проблемы мы создали два новых проекта дорожной карты. Мы инвестируем в кластер только с CPU рядом с нашим локальным хранилищем для сессий разработки, сосредоточенных на подготовке данных. Это позволит сохранить мощности обучающего кластера для задач, которым они действительно необходимы. Кроме того, мы планируем создать восстанавливаемые сессии для этих задач на CPU. Это позволит продолжать вытеснять задачи по завершении их минимального времени выполнения для обслуживания или распределения времени, одновременно восстанавливая сессию в другом месте без её повторной сборки исследователем. Мы сможем сохранить операционные преимущества и преимущества планирования новой системы, улучшив при этом пользовательский опыт.
Мы продолжаем следить за возникающими проблемами. Один из возможных рисков, который мы изучаем, — фрагментация ресурсов, способная привести к увеличению времени ожидания наиболее крупных задач. Мы предполагаем, что защита минимального времени выполнения применяется к типам задач, которые раньше использовали механизмы вытеснения, чтобы превышать командный лимит одновременно используемых GPU. Раньше такие задачи можно было прервать в любой момент, что потенциально приводило к потере этого времени, но одновременно облегчало планирование крупных задач. Теперь у планировщика может быть меньше возможностей одновременно прервать множество задач для размещения крупной ожидающей задачи. Сейчас мы используем инструменты симуляции, чтобы воспроизвести эту проблему, одновременно измеряя фактические показатели в рабочей среде.
Будущее
Глядя дальше описанной здесь работы над планированием, мы стремимся достичь вершины пирамиды — использования ресурсов. Необходимо обеспечить максимально эффективное выполнение начальной загрузки, создания контрольных точек и самих приложений обучения, чтобы повысить ценность времени, выделенного каждой задаче.
Если вы хотите решать подобные задачи в тесном сотрудничестве с исследователями, мы приглашаем вас ознакомиться с открытыми инженерными вакансиями в Ai2.


Сообщество
· Зарегистрируйтесь или войдите, чтобы оставить комментарий
Переведено автоматически с английского. Оригинал статьи — по ссылке ниже.