Бележки към изданието на Apertus 1.5


Apertus 1.5 представлява продължаващо предварително обучение на модела от първо поколение: към модела 8B са добавени 4 трилиона токена текстови и мултимодални обучаващи данни, а към модела 70B — 2 трилиона токена, или общо съответно 19T и 17T. Както при всяко издание на Apertus, моделите са напълно отворени: отворени тегла, отворени данни, отворени ценности и пълни подробности за обучението.
Основни подобрения
- Нативно мултимодално разбиране: Apertus 1.5 приема изображения и аудио заедно с текст, като включва документи, диаграми и снимки в разговора. Моделите могат също да обработват говорима реч, макар че това все още е експериментално.
- Режим на мислене: Моделите могат да бъдат превключени в режим на мислене, за да разсъждават върху входа, преди да отговорят, което подобрява представянето при задачи, изискващи разсъждение.
- Дълъг контекст: Контекстният прозорец нараства до 262 144 токена — четирикратно увеличение спрямо Apertus 1.0.
- Подобрено следване на инструкции: По-доброто придържане към инструкциите в сравнение с Apertus 1.0 осигурява по-предвидими и точни отговори.
- Подобрено използване на инструменти: Моделите са обучени за по-добра интеграция с инструменти, което позволява по-ефективно използване на външни инструменти и API.
- Отворени ценности: По-силно придържане към Хартата на Apertus, което осигурява прозрачност по отношение на ценностите и принципите на модела.
Процес на обучение
 Пълният обучителен процес на Apertus 1.5
Мултимодалност чрез токенизатора
Въвеждаме мултимодалността в моделите v1.5 по начин на ранно сливане, при който изображенията и аудиото влизат в Apertus като дискретни токени в същата последователност като текстовите токени, вместо да се използва отделен визуален енкодер. Изображенията се токенизират с токенизатора Emu3.5 (изображение с размер 512×512 се превръща в 1024 токена), а аудиото — с WavTokenizer (40 токена в секунда). Разширяваме само речника, така че архитектурата остава непроменена, а обучението се изпълнява със скоростта на обучение само с текст. Моделите разбират изображения и аудио, но генерират само текст.

Предварително обучение
Започвайки от Apertus 1.0, продължаваме предварителното обучение на четири етапа:
- Несдвоени данни: текст плюс самостоятелни изображения и аудио, така че моделът да научи новите модалности.
- Сдвоени данни: двойки изображение–надпис и аудио–транскрипция, така че моделът да ги съгласува с езика.
- Охлаждане: по-качествени данни с повече математика и код.
- Дълъг контекст: прозорецът нараства постепенно от 8k до 262k токена.
Като цяло повече от половината обучаващи токени са само текстови, което запазва езиковите способности на Apertus 1.0. Текстовите данни са обновени с източници като FineWeb2-HQ+, FinePDFs и Nemotron-CC. Всички нови данни, включително мултимодалните, отговарят на същия стандарт като преди: публично достъпни, с разрешителен лиценз и със зачитане със задна дата на отказите чрез robots.txt. Всеки източник е посочен в apertus-data-transparency.
Дообучение
Дообучението протича на пет етапа: SFT → SFT с дълъг контекст → RL → DPO → съгласуване с хартата (SDPO).
- SFT върху 3,7 милиона текстови примера плюс изображения и речеви данни. Следи от разсъждения се добавят само към подкани, които моделът не може да реши самостоятелно без тях. Данните за използване на инструменти са ограничени до траектории, проверени чрез изпълнение. Публикуваме текстовия SFT микс, който използвахме, в Hugging Face.
- SFT с дълъг контекст при пълния прозорец от 262k възстановява способността за работа с дълъг контекст, която краткоконтекстовият SFT влошава.
- Подсилващо обучение с проверими награди (RLVR) върху около 350k подкани по математика, програмиране, следване на инструкции, многоезичност и зрение, като се редуват включен и изключен режим на мислене.
- DPO със сравнителни двойки, оценени от съдии, подобрява качеството на разговорите, използването на инструменти и безопасността. Публикуваме набора от предпочитания и обучаващите двойки.
- SDPO съгласува модела с Хартата на Apertus чрез обратна връзка от съдии и самодестилация.
Резултати от оценяването
Наред с разширените възможности на модела значително разширихме и обхвата на оценяването. В допълнение към съществуващите текстови оценки, използвани за Apertus 1.0, добавихме мултимодални оценки (изображения и аудио), както и оценки на режима на мислене.
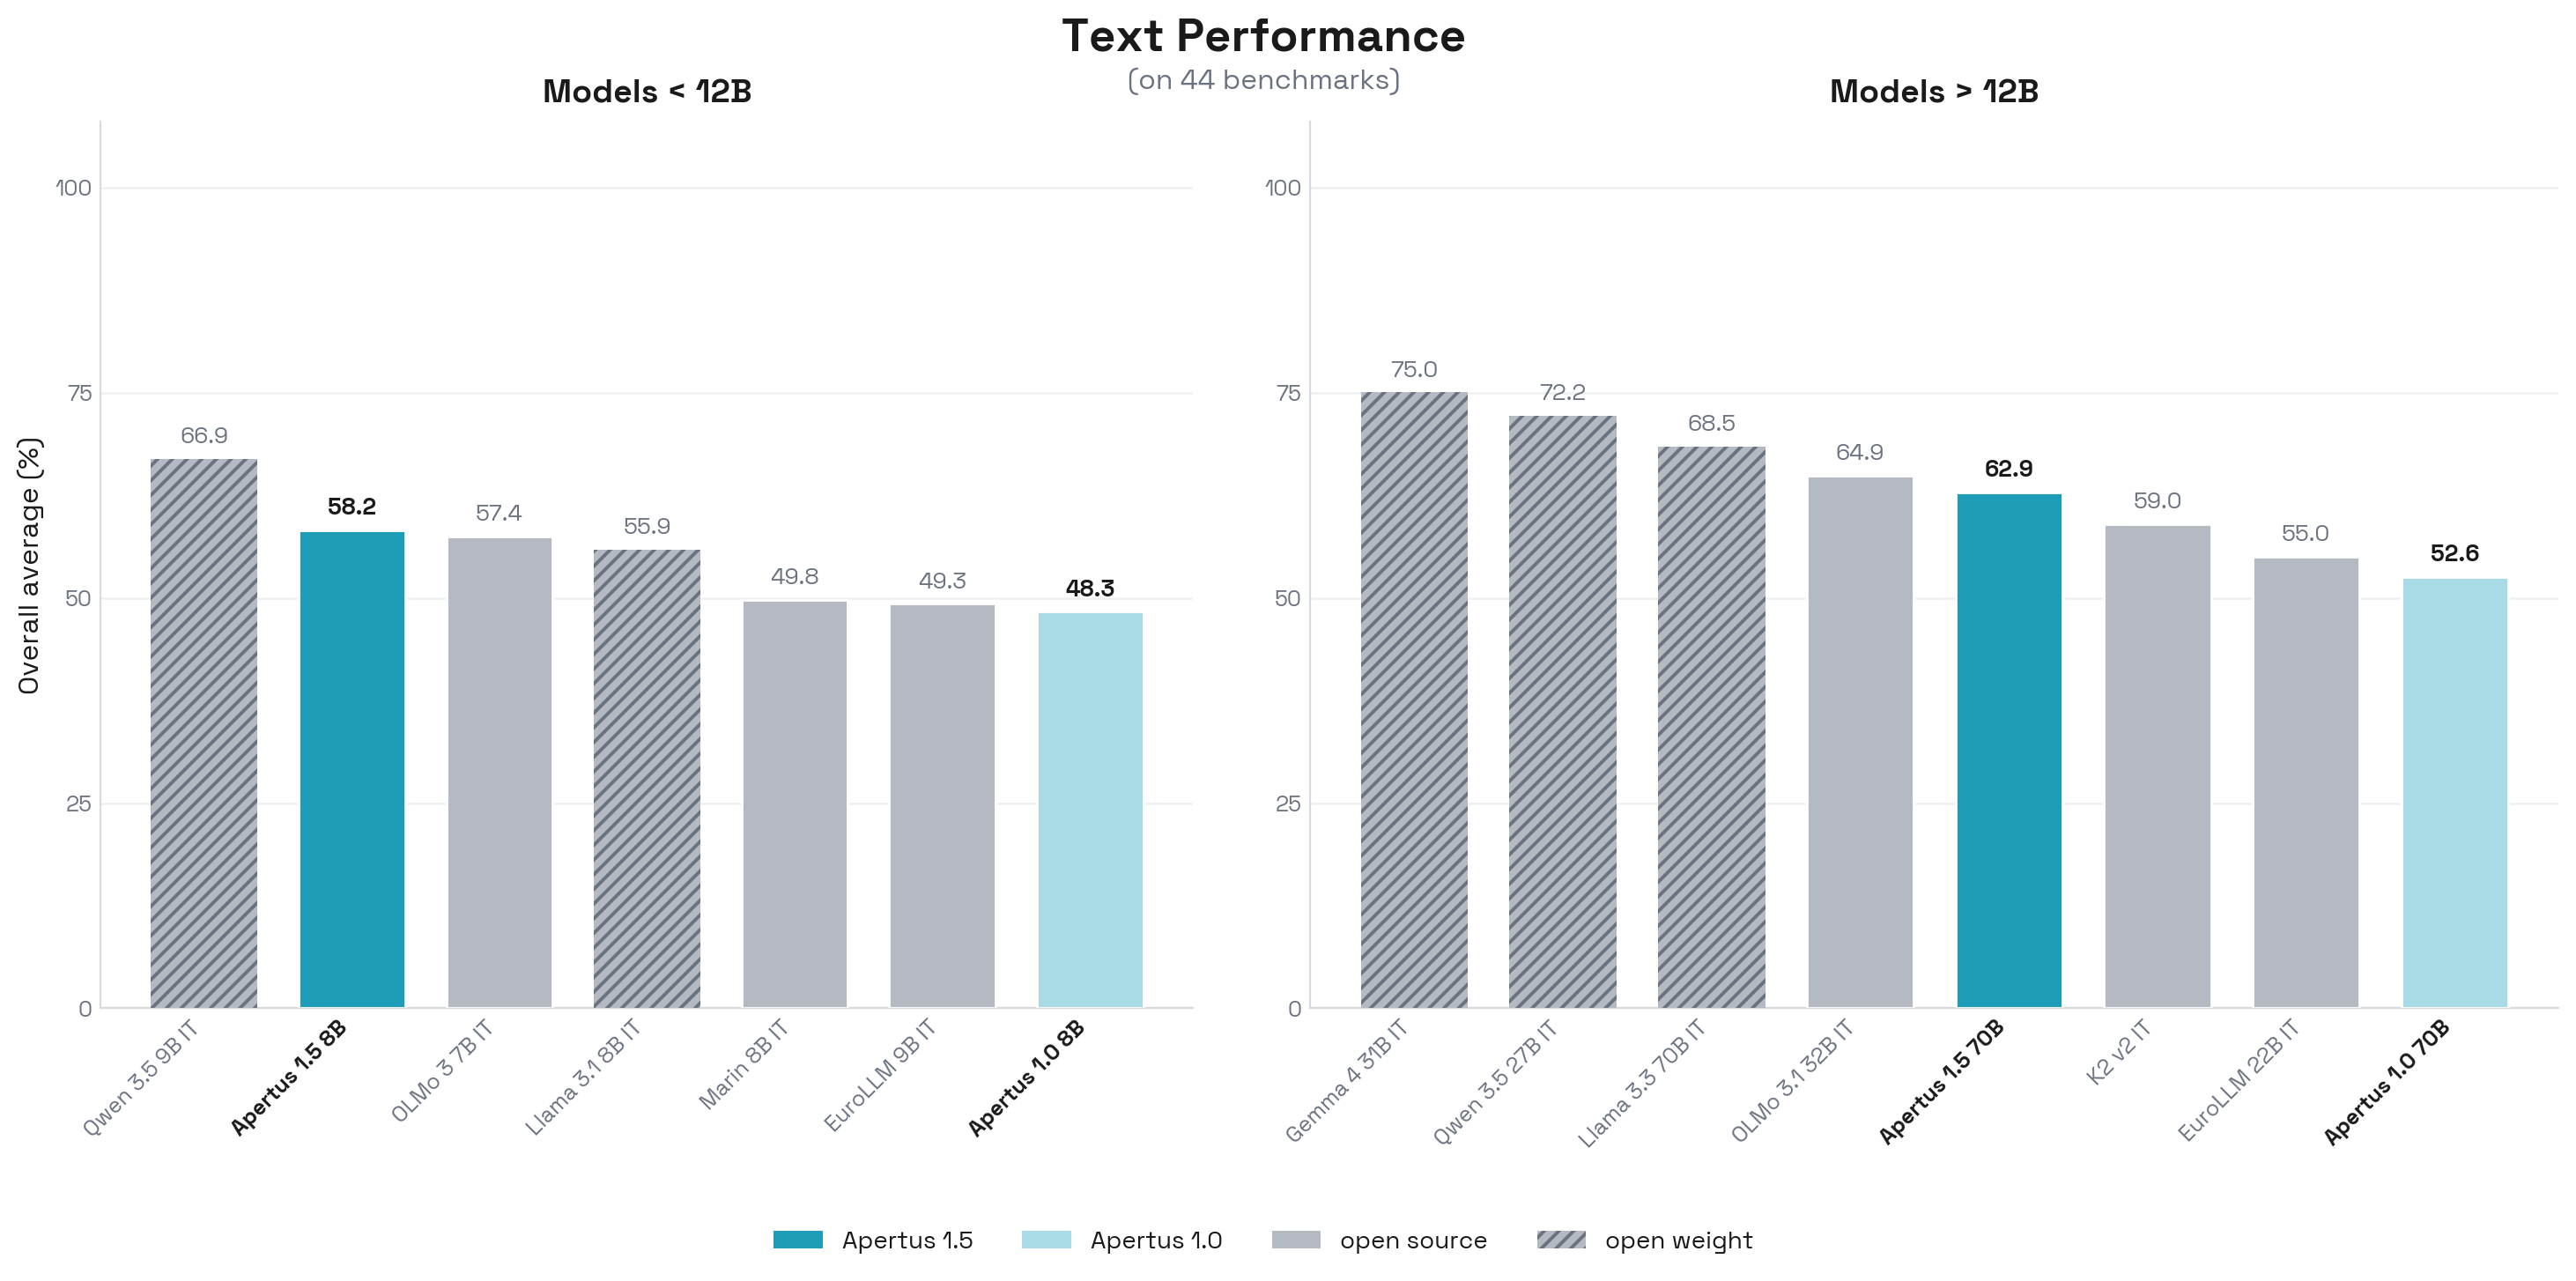
Мултимодалните оценки се извършват чрез процеса MLLM-eval-suite, който обединява две основни рамки за мултимодално оценяване — lmms-eval и VLMEvalKit. Добавихме също поредица от текстови бенчмаркове, както и разширено оценяване на превода и многоезичните способности, безопасността и използването на инструменти. Те са достъпни в нашето хранилище за оценяване след дообучение, базирано на форка на lm-evaluation-harness.
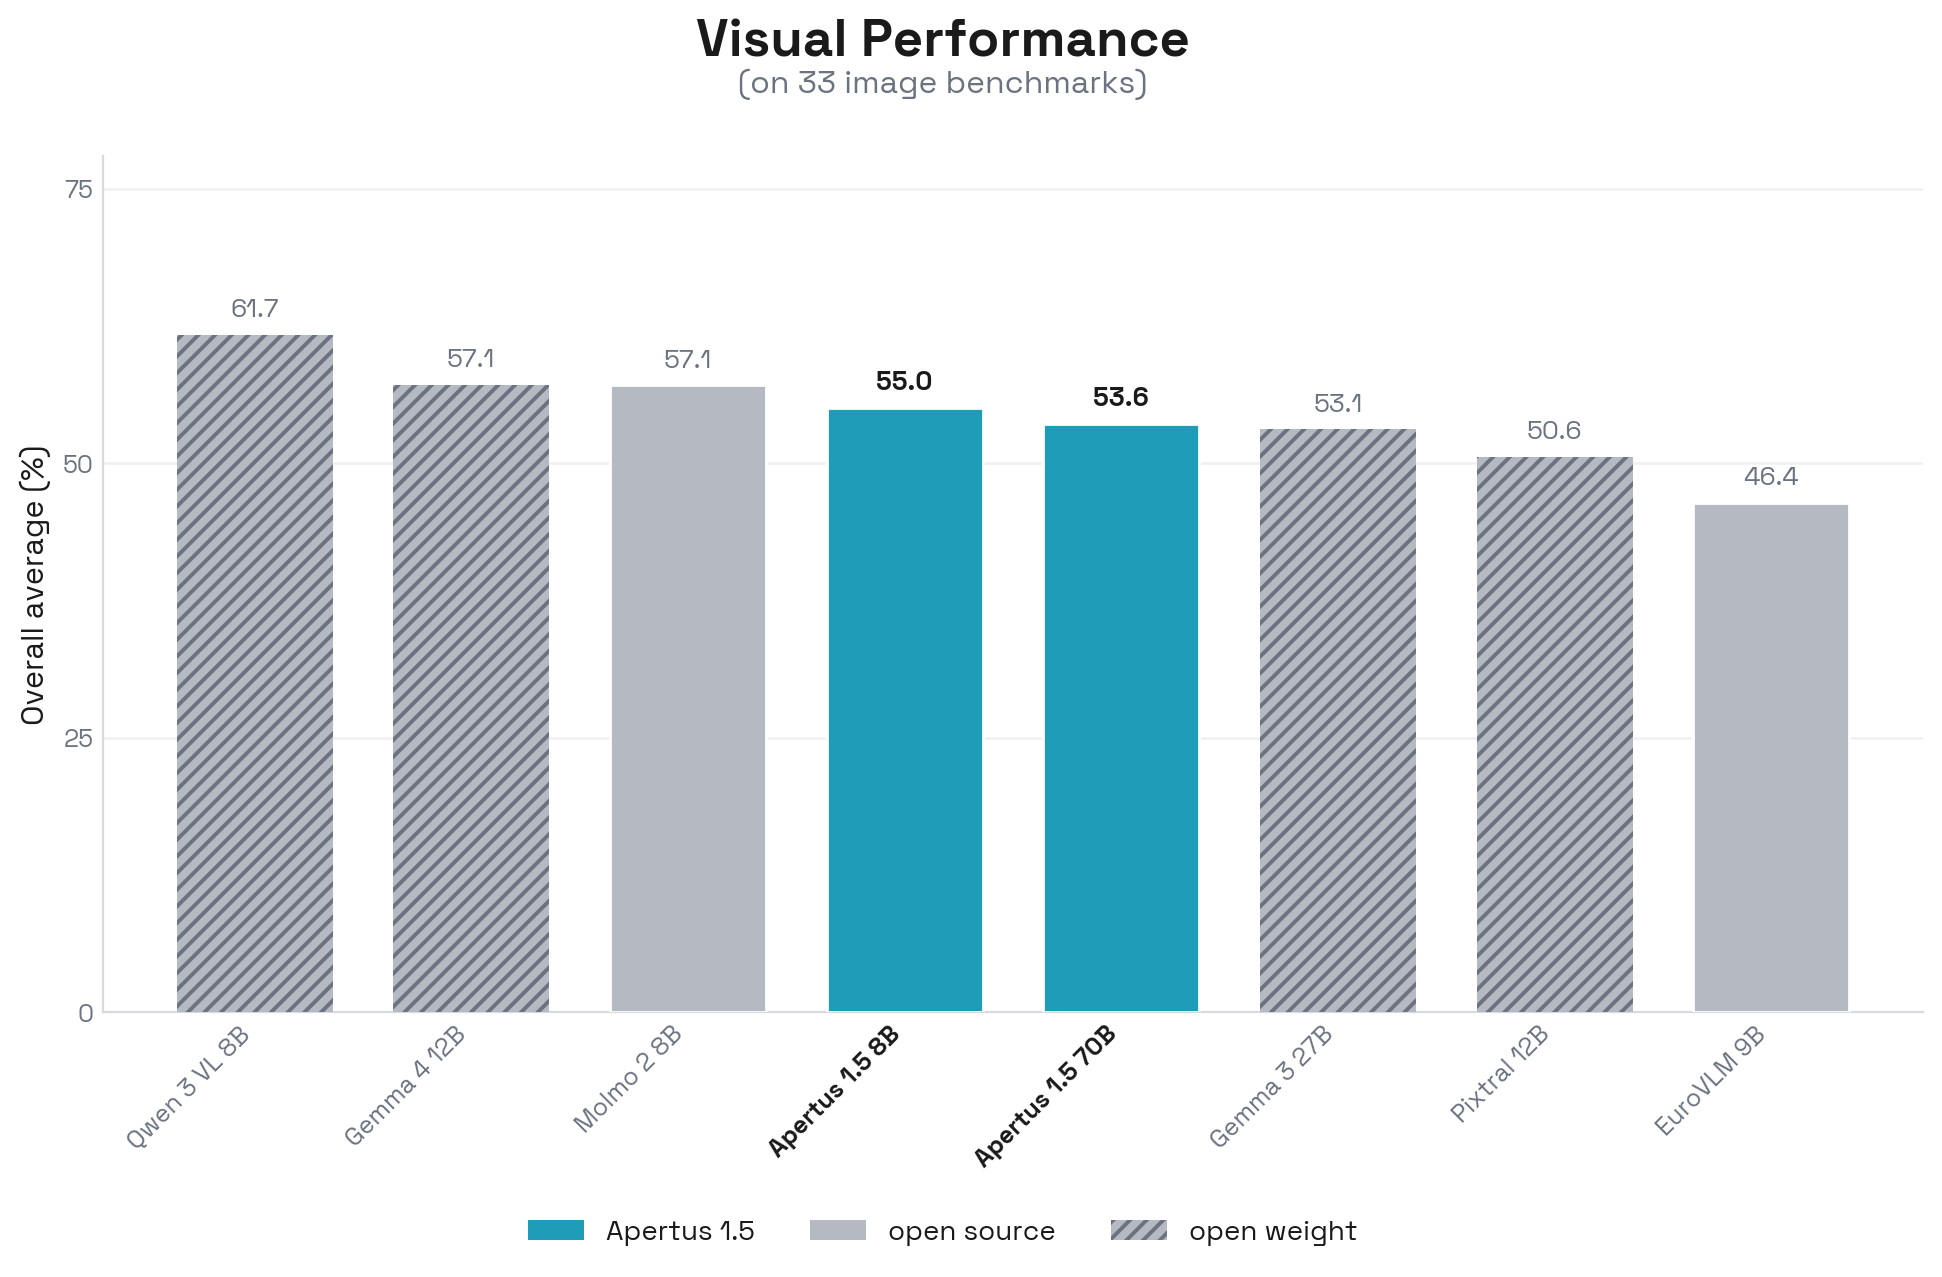
Макар все още да изостава от водещите модели с отворени тегла, новото издание значително подобрява представянето при програмиране и следване на инструкции, като Apertus 1.5 8B превъзхожда сходни по размер модели с отворени тегла при задачи за следване на инструкции и многоезични задачи. Мисленето допълнително подобрява представянето при предизвикателни бенчмаркове, изискващи интензивно разсъждение, като AIME. Мултимодалното представяне на модела е по-близо до това на Gemma 4 12B и други актуални модели с отворени тегла. Мултимодалното представяне на Apertus 1.5 е конкурентно при пространственото разбиране сред моделите с отворени тегла и при разбирането на документи и диаграми сред моделите с отворен код.
Благодарим също на нашите сътрудници и външни оценители за помощта им при ефективното измерване на възможностите на Apertus. По-специално, Apertus 1.5 показва силно представяне при задачи по швейцарско право, наравно с водещи модели с отворени тегла (блог, код). Освен това в Last Translation Benchmark Apertus 1.5 8B демонстрира възможности за машинен превод, съпоставими с GPT-OSS-20B, и превъзхожда модели като Claude Haiku 4.5 или Google Translate (класиране, статия).
Карти за оценяване: Apertus ❤️ EvalEval
Apertus си сътрудничи с EvalEval Coalition, за да гарантира напълно прозрачно и възпроизводимо бенчмаркиране. Публикуваме резултатите от Apertus 1.5 в схемата Every Eval Ever (EEE) — споделен формат, който отчита не само резултатите, но и кой е извършил оценяването, как е бил достъпен моделът, настройките за генериране и как трябва да се интерпретира всяка метрика: подробности, които обичайно липсват в класациите и често обясняват защо сходни на вид резултати се различават.
Резултатите са показани в картата за оценяване по-долу, която обединява данните от изпълнението с метаданните за бенчмарка и модела в един интерпретируем запис, а също са достъпни чрез Community Evals на Hugging Face. Това е същата инфраструктура, която Институтът за безопасност на изкуствения интелект на Обединеното кралство използва, за да публикува оценките си открито. Тъй като текстовите ни оценки се изпълняват върху публичния ни форк на lm-evaluation-harness, който EEE поддържа чрез специален конвертор, всеки може да ги изпълни отново и да сравни резултатите си с нашите при идентични настройки.
Структурираното отчитане на оценяването е важно и извън научните изследвания. EvalEval е съпоставил картите за оценяване с изискванията за управление на ИИ, включително член 55 от Закона на ЕС за ИИ и Кодекса за практики за GPAI, и е установил, че схемата EEE може да представи 56 от 60-те елемента за отчитане на оценяването, изисквани от тези рамки. Това съответства на начина, по който вече публикуваме Apertus: наред с моделите публикуваме публично резюме на съдържанието за обучение и доброволно — документ с кодекс за практики. Машинночетимите записи за оценяване са естествената следваща стъпка: те улесняват регулаторите, внедряващите организации и изследователите при намирането, интерпретирането и сравняването на доказателствата зад даден модел.
Ангажирани сме да насърчаваме възпроизводимото и прозрачно оценяване чрез картите за оценяване и схемата EEE и призоваваме други разработчици на модели да отчитат резултатите си по същия начин, така че резултатите да могат да се сравняват между модели и организации.
Възпроизводимост на Apertus 1.5
Всички рецепти, аблации и смеси от данни са документирани в техническия доклад. Целта ни е да популяризираме отворената разработка на модели, като направим процеса на обучение на v1.5 публичен и достъпен. Междинните контролни точки са хоствани в нашата колекция Apertus 1.5 в Hugging Face, включително базовите тегла, SFT, RLVR и DPO, както и подбраните смеси от обучаващи данни/персонализирани набори от данни в колекцията от набори от данни Apertus 1.5. Споделянето им позволява на изследователите да проучат как всеки етап променя поведението на модела.
Докладът обхваща множество аблации на ефекта от данните за дообучение на различните етапи, при които установихме, че мултимодалните данни, смесени с текстови данни по време на SFT, помагат за подобряване на представянето във всички модалности. Установихме също, че ползите от мултимодалните следи на разсъждение се запазват при последващото подсилващо обучение само с текст: започвайки от контролна точка за SFT, обучена с мултимодални следи, RL подобрява математическите способности повече, отколкото при започване от контролна точка само с текст, а предимството при задачите за разсъждение се запазва през цялото обучение.
| Модели | 8B | 70B |
|---|---|---|
| Предварително обучение (база с дълъг контекст) | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| Надзиравано дообучение (SFT) | Apertus-v1.5-8B-SFT | Apertus-v1.5-70B-SFT |
| Подсилващо обучение (RLVR) | Apertus-v1.5-8B-RLVR | Apertus-v1.5-70B-RLVR |
| Съгласуване с предпочитанията (DPO) | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B (финален) |
| Съгласуване с хартата (SDPO) | Apertus-v1.5-8B (финален) | – |
| Етап | Данни | Код / рецепта |
|---|---|---|
| Предварително обучение: етапи 1–2 (несдвоени, сдвоени) | Всички източници с версии и лицензи в apertus-data-transparency; рецепти за обработка на изображения и аудио в multimodal-data | Megatron-LM, скриптове за стартиране в pretrain-code, apertus-omni-tokenizer, benchmark-image-tokenizer, benchmark-audio-tokenizer (вкл. конструктор за преплетена реч–текст) |
| Предварително обучение: етап 3 (охлаждане) | apertus-data-transparency; подбрани набори от изображения NASA, Our World in Data, Smithsonian, swisstopo | Megatron-LM, скриптове за стартиране в pretrain-code |
| Разширяване на дългия контекст | apertus-data-transparency; синтетични задачи за дълъг контекст в LongContextQA | Megatron-LM, скриптове за стартиране в pretrain-code |
| SFT | Apertus-v1.5-SFT-mix (мултимодалният SFT микс е посочен в доклада) | posttraining-data, Megatron-LM (скриптове за стартиране на SFT) |
| SFT с дълъг контекст | Подмножества на SFT микса (посочени в доклада), плюс задачи от LongContextQA | Megatron-LM |
| RL (RLVR) | Смес, посочена в доклада | verl, verl-recipe |
| DPO | Apertus-v1.5-Preference-Pool (анотирани завършвания), Apertus-v1.5-Preference-Data (двойки) | posttraining, verl |
| SDPO (съгласуване с хартата, само 8B) | gretelai/gretel-safety-alignment-en-v1 | self-distillation |
Наличност на моделите
Proton Lumo и Infomaniak Euria са две широко използвани приложения, които наскоро интегрираха Apertus 1.5. Тези внедрявания, наред с други, са свързани в Community Showcase — вижте тази дискусия за предварителен преглед.
Достъпът до Apertus 1.5 под формата на API за разработчици е обявен от редица доставчици, включително Swisscom, Infomaniak, Phoeniqs и други компании, посочени в нашето ръководство за общодостъпност. Докладът предоставя и подробности за начина, по който работим с външни оценители за тестване и подготовка на моделите.
Технически инструкции за стартиране на моделите са налични в картите на моделите за изданията на Apertus в Hugging Face и в нашето ръководство за бърз старт.
Как да се включите
Благодарим ви, че прочетохте тази публикация в блога и сте част от нашата общност! Току-що отбелязахме пет милиона изтегляния в статистиката на Hugging Face 🤗 и не забавяме темпото. На неотдавнашната среща на върха AI+X в Цюрих екипът ни обяви пътната карта за Apertus 2.0: разредена/MoE архитектура, около 600B общо параметри, разширен график за обучение, като приоритети са агентите, математиката и програмирането.
В обобщение: каним ви да прочетете доклада ни, да изтеглите моделите, да разгледате междинните контролни точки, да дообучите теглата и да възпроизведете оценяванията ни. Въпроси, които още не са разгледани в нашите публикации или в раздела с често задавани въпроси на уебсайта, винаги са добре дошли, а също така бихме искали да чуем кои теми биха били най-полезни за общността при бъдещи задълбочени анализи.
Ако разработвате с Apertus или го използвате, моля, попълнете формуляра за Showcase и се свържете с нас чрез възможностите на нашата страница за контакти. Очакваме с нетърпение да представим още проекти, да научим какво разработвате и да чуем как Apertus може да бъде подобрен!
Цитиране
Project Apertus и др. „Apertus 1.5: From Open Text Models to Open Multimodal Reasoners.“ arXiv:2610.15542. Предпечат, arXiv, 11 октомври 2026 г. https://doi.org/10.48550/arXiv.2610.15542.
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and Yassine Turki and Vinko Sabolčec and Valentina Pyatkin and Tommy Chu and Sven Najem-Meyer and Sean F. Carroll and Robert Smith and Raphael Kreft and Oscar Alessandro Tazza and Oleg Lavrovsky and Nicola Irmiger and Matteo Santelmo and Marian Schneider and Juan García Giraldo and Hanna Yukhymenko and Eduard Ďurech and Davit Melikidze and Dani Tamayo and Bettina Messmer and Aryan Ahadinia and Anunay Yadav and Allen Huang and Ahmad Fraij and Alessandro Bombarda and Alex Padula and Alexander Hägele and Alexander Sternfeld and Anna Hedström and Anna Kosovskaia and Arthur Wuhrmann and Arundhati Balasubramaniam and Badr Al Mahouri and Barna Pasztor and Bartosz Szostakiewicz and Bich Ngoc Doan and Bryan Schmid and Burak Sezen and Camille Challier and Clément Charmillot and Dana Shayakhmetova and Daniel Perruchoud and David Brüggemann and David Isztl and Elia Palme and Emma Anastassova and Fabian Bösch and Faruk Zahiragić and Fawzi Roberto Mohamed and Fiona Panicali and Florian Kolly and Flynn Guerra and Francesco Monti and Frederike Lübeck and Gennaro Oliva and Haofeng Yang and Haoliang Shang and Helen El Khoury and Henrique Mendonça and Jannis Vamvas and Jérome Landolt and Jessica Lam and Jingchun Xiao and Jonathan Coles and Joshua Oyebanji and Khanh Nguyen and Konstantinos Pitas and Lasse B. Strand and Li Mi and Loïc Deslarzes and Lorenzo Baggi and Lorenzo Noci and Luca Baumann and Luca Sartori and Lukas Drescher and Marco De Negri and Marco Passerini and Mark Klein and Marko Stojanovic and Martin Majsec and Matin Ansaripour and Mattea Busato and Mauro Pellonara and Max Neuwinger and Michael Graber and Michal Tešnar and Michelle Wastl and Miguel Gila and Mikolaj Boronski and Morgane Magnin and Moritz Reihs and Mukhammadali Sayfiddinov and Nathan Ranchin and Nicolas Cuveillier and Oscar Wohlfahrt and Qianqian Zou and Rada Kamysheva and Rita Sevastjanova and Roman Machacek and Sebastian Keller and Simon Matrenok and Simon Pierre and Stefano Schuppli and Suei-Wen Chen and Szabina Horváth-Mikulas and Taliesin Perez and Thilo Spinner and Thomas Kleine Buening and Tim Robinson and Tymoteusz Kwiecinski and Vilém Zouhar and Vinzenz Thoma and Xiaozhe Yao and Yannick Metz and Yuhei Fukuhara and Yusif Askari and Zixuan Chen and Alexander Ilic and Ana Klimovic and Andreas Krause and Andrei Kucharavy and Elliott Ash and Joost VandeVondele and Martin Rajman and Mennatallah El-Assady and Thomas Schulthess and Timo Kehrer and Torsten Hoefler and Antoine Bosselut and Martin Jaggi and Imanol Schlag},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}
Модели, споменати в тази статия 9
Набори от данни, споменати в тази статия 9
Статии, споменати в тази статия 1
Колекции, споменати в тази статия 2
Общност
· Регистрирайте се или влезте, за да коментирате


Модели, споменати в тази статия 9
Набори от данни, споменати в тази статия 9
Статии, споменати в тази статия 1
Колекции, споменати в тази статия 2
Преведено автоматично от английски. Оригиналната статия е на връзката по-долу.