Примечания к выпуску Apertus 1.5


Apertus 1.5 — это продолжение предварительного обучения модели первого поколения: к модели 8B добавлено 4 триллиона токенов текстовых и мультимодальных обучающих данных, а к модели 70B — 2 триллиона токенов; общий объём составил соответственно 19 и 17 триллионов токенов. Как и все выпуски Apertus, модели полностью открыты: открытые веса, открытые данные, открытые ценности и полные сведения об обучении.
Ключевые улучшения
- Нативное мультимодальное понимание: Apertus 1.5 принимает изображения и аудио наряду с текстом, добавляя в диалог документы, схемы и фотографии. Модели также могут обрабатывать устную речь, хотя эта возможность пока носит экспериментальный характер.
- Режим рассуждений: модели можно переключить в режим рассуждений, чтобы перед ответом проанализировать входные данные; это повышает результаты в задачах, требующих рассуждений.
- Длинный контекст: контекстное окно увеличено до 262 144 токенов — в четыре раза по сравнению с Apertus 1.0.
- Улучшенное следование инструкциям: более точное соблюдение инструкций по сравнению с Apertus 1.0 обеспечивает более предсказуемые и точные ответы.
- Улучшенное использование инструментов: модели обучены для более эффективной интеграции инструментов, что позволяет лучше использовать внешние инструменты и API.
- Открытые ценности: более строгое соответствие Хартии Apertus обеспечивает прозрачность ценностей и принципов модели.
Процесс обучения
 Полный конвейер обучения Apertus 1.5
Мультимодальность через токенизатор
В моделях v1.5 мы добавляем мультимодальность методом раннего объединения: изображения и аудио поступают в Apertus в виде дискретных токенов в той же последовательности, что и текстовые токены, вместо использования отдельного визуального кодировщика. Изображения токенизируются с помощью токенизатора Emu3.5 (изображение 512×512 превращается в 1 024 токена), а аудио — с помощью WavTokenizer (40 токенов в секунду). Мы лишь расширяем словарь, поэтому архитектура остаётся неизменной, а обучение идёт с той же скоростью, что и для одного текста. Модели понимают изображения и аудио, но генерируют только текст.

Предварительное обучение
Начиная с Apertus 1.0, мы продолжаем предварительное обучение в четыре этапа:
- Несвязанные данные: текст, а также отдельные изображения и аудио, чтобы модель освоила новые модальности.
- Связанные данные: пары «изображение — подпись» и «аудио — расшифровка», чтобы модель сопоставляла их с языком.
- Охлаждение: более качественные данные с увеличенной долей математики и кода.
- Длинный контекст: окно постепенно увеличивается с 8 тыс. до 262 тыс. токенов.
В целом более половины обучающих токенов относятся только к тексту, что сохраняет языковые способности Apertus 1.0. Текстовые данные обновлены источниками, такими как FineWeb2-HQ+, FinePDFs и Nemotron-CC. Все новые данные, включая мультимодальные, соответствуют прежним требованиям: они общедоступны, распространяются по разрешительным лицензиям, а отказы от использования, указанные в robots.txt, учитываются задним числом. Все источники перечислены в apertus-data-transparency.
Дообучение
Дообучение проходит в пять этапов: SFT → SFT с длинным контекстом → RL → DPO → согласование с хартией (SDPO).
- SFT на 3,7 млн текстовых примеров, а также данных изображений и речи. Цепочки рассуждений добавляются только к тем запросам, которые модель ещё не может решить без них. Данные об использовании инструментов ограничены траекториями, проверенными выполнением. На Hugging Face мы публикуем использованный текстовый набор SFT.
- SFT с длинным контекстом при полном окне в 262 тыс. токенов восстанавливает способность работать с длинным контекстом, которую разрушает SFT на коротком контексте.
- RL с проверяемыми наградами (RLVR) примерно на 350 тыс. математических, кодовых, мультиязычных запросах, запросах на следование инструкциям и визуальных запросах, с чередованием включённого и выключенного режима рассуждений.
- DPO с парами предпочтений, оценёнными судьёй, улучшает качество диалога, использование инструментов и безопасность. Мы публикуем набор предпочтений и обучающие пары.
- SDPO согласует модель с Хартией Apertus посредством обратной связи от судьи и самодистилляции.
Результаты оценки
Одновременно с расширением возможностей модели мы значительно увеличили охват оценивания. Помимо существующих текстовых оценок, использованных для Apertus 1.0, мы добавили мультимодальные оценки (изображения и аудио), а также оценки режима рассуждений.
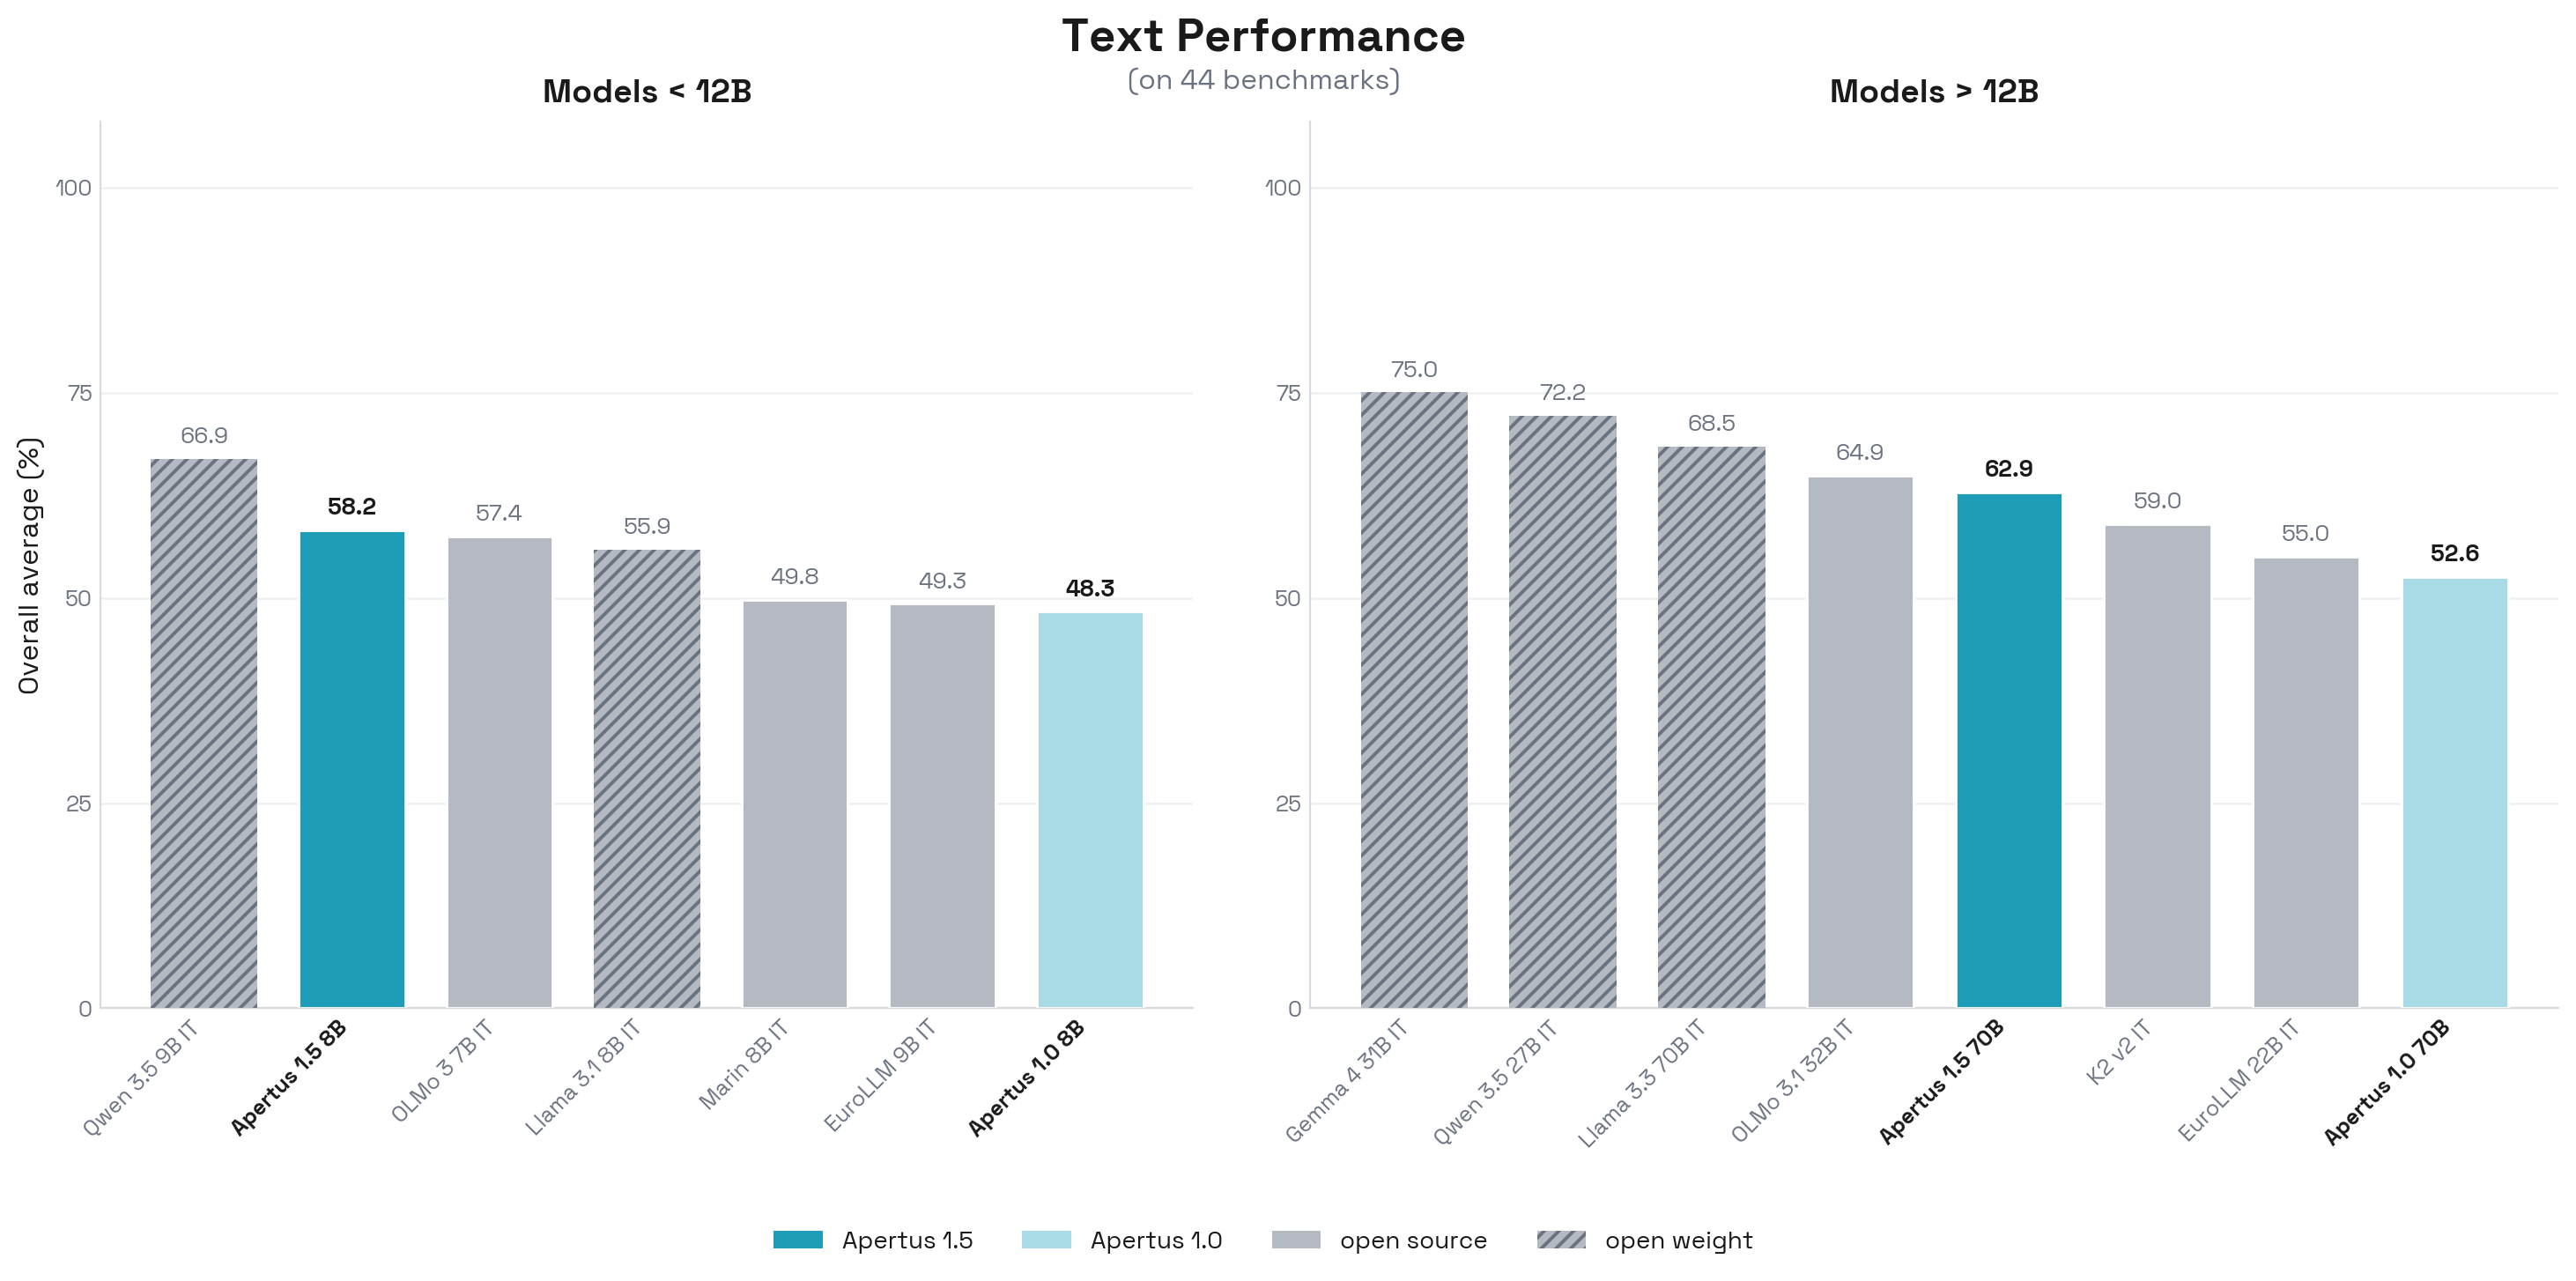
Мультимодальные оценки проводятся с помощью конвейера MLLM-eval-suite, объединяющего две основные платформы мультимодальной оценки — lmms-eval и VLMEvalKit. Мы также добавили ряд текстовых тестов, а также расширенное тестирование возможностей перевода и работы с несколькими языками, безопасности и использования инструментов. Их можно найти в нашем репозитории оценок для дообучения, основанном на форке lm-evaluation-harness.
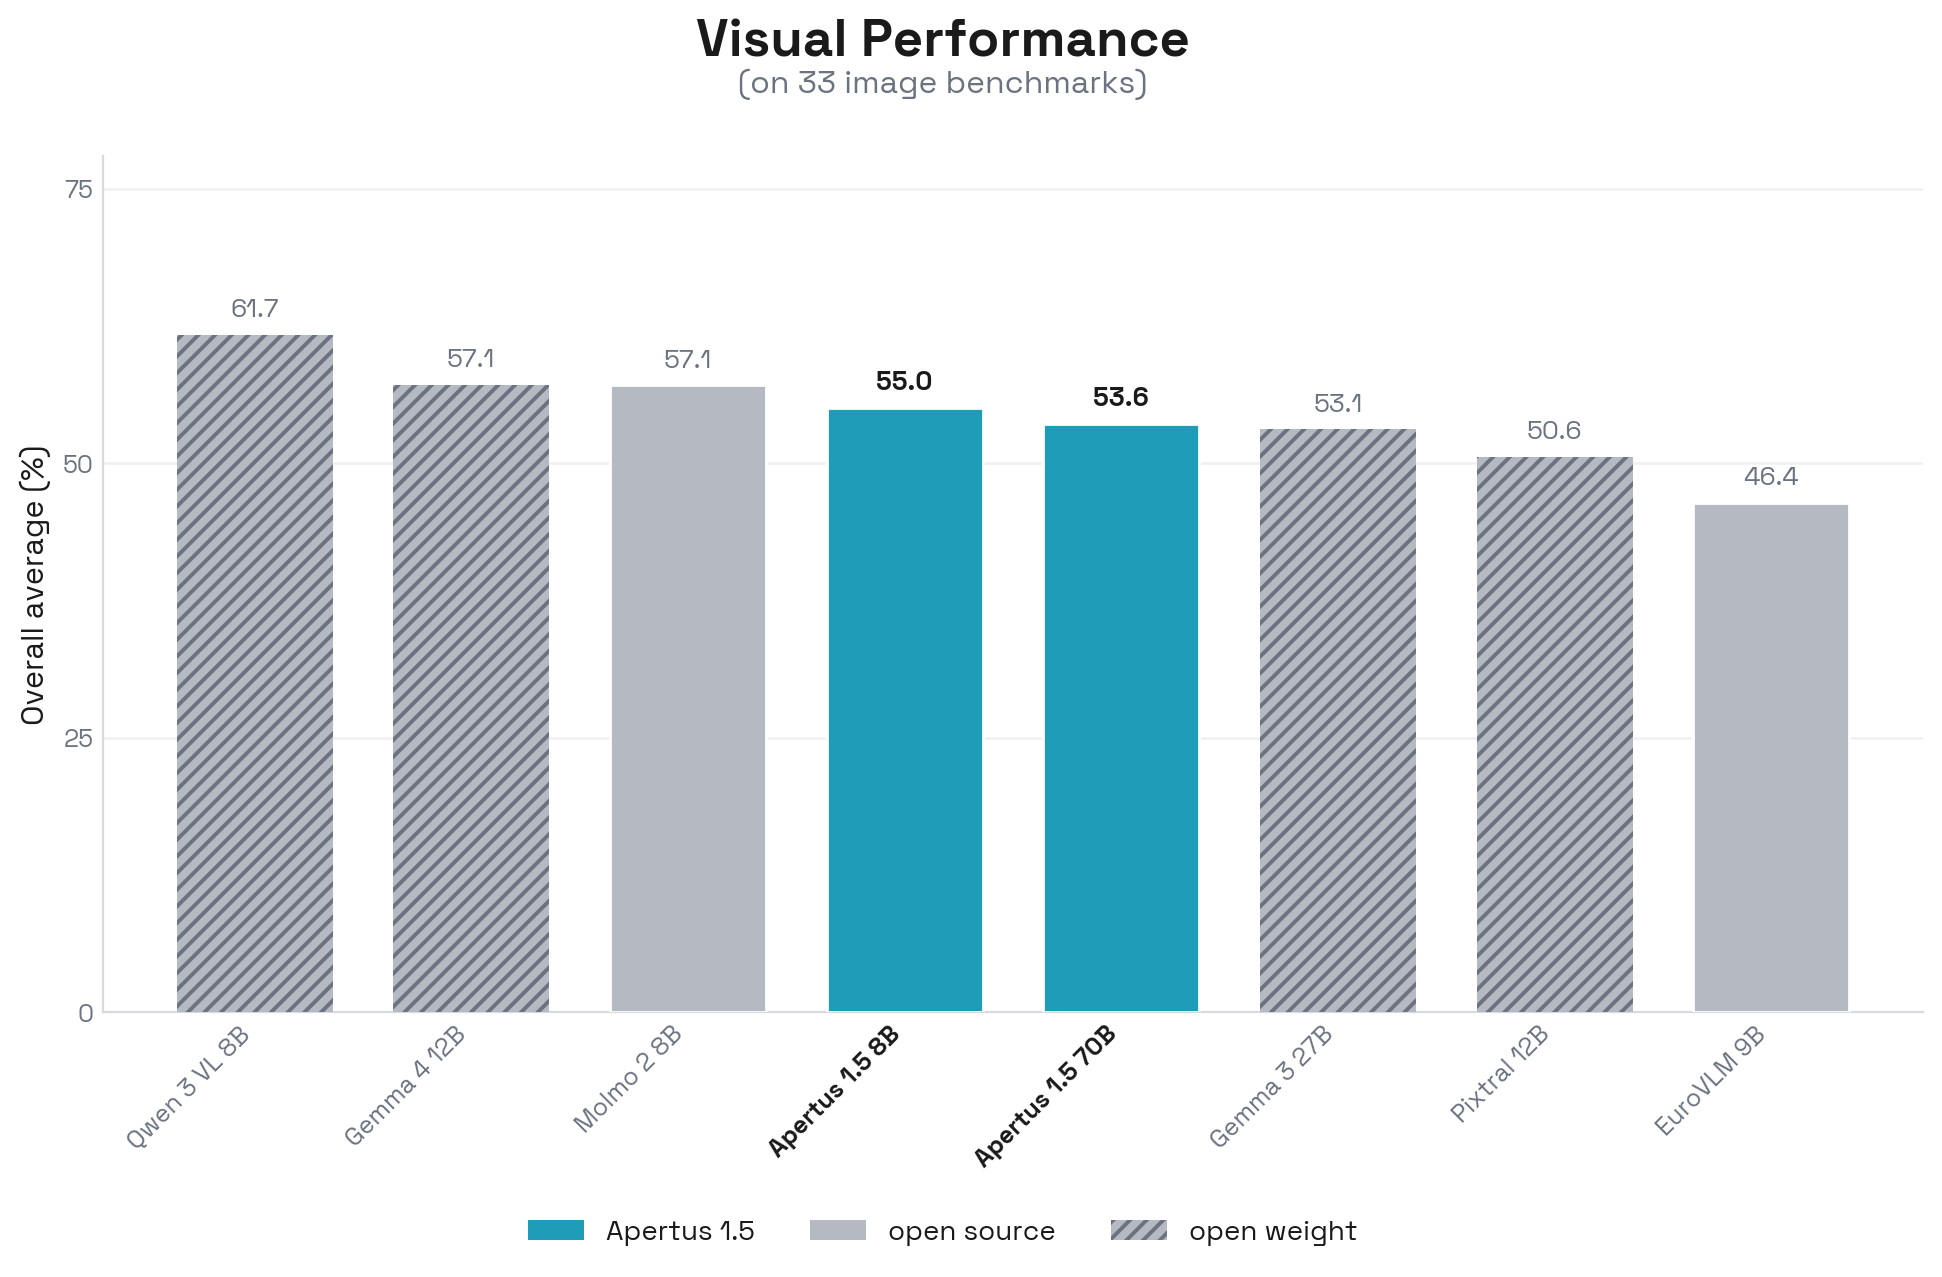
Хотя новый выпуск всё ещё уступает передовым моделям с открытыми весами, он значительно улучшил результаты в программировании и следовании инструкциям: Apertus 1.5 8B превосходит модели сопоставимого размера с открытыми весами в задачах следования инструкциям и мультиязычных задачах. Режим рассуждений дополнительно повышает результаты в сложных тестах с упором на рассуждения, таких как AIME. Мультимодальные результаты модели ближе к показателям Gemma 4 12B и других современных моделей с открытыми весами. Apertus 1.5 демонстрирует конкурентоспособные среди моделей с открытыми весами результаты в пространственном понимании и среди моделей с открытым исходным кодом — в понимании документов и диаграмм.
Мы также благодарим наших сотрудников и внешних оценщиков за помощь в эффективном тестировании возможностей Apertus. В частности, Apertus 1.5 показывает высокие результаты в задачах по швейцарскому праву, находясь на уровне ведущих моделей с открытыми весами (статья, код). Кроме того, в Last Translation Benchmark модель Apertus 1.5 8B демонстрирует возможности машинного перевода, сопоставимые с GPT-OSS-20B и превосходящие модели вроде Claude Haiku 4.5 или Google Translate (таблица лидеров, статья).
Карточки оценок: Apertus ❤️ EvalEval
Apertus сотрудничает с коалицией EvalEval, чтобы обеспечить полностью прозрачное и воспроизводимое тестирование. Мы публикуем результаты Apertus 1.5 в формате схемы Every Eval Ever (EEE) — общем формате, в котором фиксируются не только оценки, но и сведения о том, кто проводил оценивание, как осуществлялся доступ к модели, какие параметры генерации использовались и как следует интерпретировать каждую метрику: это детали, которых часто не хватает в таблицах лидеров и которые нередко объясняют различия между похожими оценками.
Результаты представлены в расположенной ниже карточке оценки Eval Card, которая объединяет данные запуска с метаданными теста и модели в одну интерпретируемую запись; они также доступны через Community Evals от Hugging Face. Это та же инфраструктура, которую Институт безопасности ИИ Великобритании использует для открытой публикации своих оценок. Поскольку наши текстовые оценки выполняются в публичном форке lm-evaluation-harness, для которого EEE поддерживает специальный конвертер, любой желающий может повторить их и сравнить свои результаты с нашими при идентичных настройках.
Структурированная отчётность об оценках важна не только для исследований. EvalEval сопоставил карточки оценок с требованиями к управлению ИИ, включая статью 55 Закона ЕС об ИИ и Кодекс практики GPAI, и выяснил, что схема EEE может представлять 56 из 60 элементов отчётности об оценках, предусмотренных этими нормативными рамками. Это соответствует нашему подходу к выпуску Apertus: наряду с моделями мы публикуем публичное резюме содержания обучения и добровольно предоставляем документ Кодекса практики. Машиночитаемые записи оценок — естественный следующий шаг: они упростят регуляторам, разработчикам и исследователям поиск, интерпретацию и сравнение свидетельств, лежащих в основе модели.
Мы стремимся продвигать воспроизводимое и прозрачное оценивание с помощью карточек оценок и схемы EEE и призываем других разработчиков моделей сообщать о результатах таким же образом, чтобы оценки можно было сравнивать между моделями и организациями.
Воспроизводимость Apertus 1.5
Все рецепты, абляции и составы данных задокументированы в техническом отчёте. Мы стремимся популяризировать разработку открытых моделей, сделав процесс обучения v1.5 публичным и доступным. Промежуточные контрольные точки размещены в нашей коллекции Apertus 1.5 на Hugging Face, включая базовые веса, SFT, RLVR и DPO, а также отобранные смеси обучающих данных и пользовательские наборы данных в коллекции наборов данных Apertus 1.5. Их публикация позволяет исследователям изучать, как каждый этап изменяет поведение модели.
В отчёте рассматриваются многочисленные абляции влияния данных дообучения на разных этапах. Мы обнаружили, что мультимодальные данные, смешанные с текстовыми во время SFT, помогают улучшить результаты во всех модальностях. Мы также выяснили, что преимущества мультимодальных цепочек рассуждений сохраняются во время последующего обучения с подкреплением только на тексте: если начать с контрольной точки SFT, обученной на мультимодальных цепочках, RL улучшает математические способности сильнее, чем при начале с текстовой контрольной точки, а преимущество в задачах на рассуждение сохраняется на протяжении всего обучения.
| Модели | 8B | 70B |
|---|---|---|
| Предварительное обучение (база с длинным контекстом) | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| Обучение с учителем (SFT) | Apertus-v1.5-8B-SFT | Apertus-v1.5-70B-SFT |
| Обучение с подкреплением (RLVR) | Apertus-v1.5-8B-RLVR | Apertus-v1.5-70B-RLVR |
| Согласование предпочтений (DPO) | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B (финальная версия) |
| Согласование с хартией (SDPO) | Apertus-v1.5-8B (финальная версия) | – |
| Этап | Данные | Код / рецепт |
|---|---|---|
| Предварительное обучение: этапы 1–2 (несвязанные, связанные) | Все источники с версиями и лицензиями в apertus-data-transparency; рецепты обработки изображений и аудио в multimodal-data | Megatron-LM, скрипты запуска в pretrain-code, apertus-omni-tokenizer, benchmark-image-tokenizer, benchmark-audio-tokenizer (включая построитель чередующихся речевых и текстовых данных) |
| Предварительное обучение: этап 3 (охлаждение) | apertus-data-transparency; отобранные наборы изображений NASA, Our World in Data, Smithsonian, swisstopo | Megatron-LM, скрипты запуска в pretrain-code |
| Расширение длинного контекста | apertus-data-transparency; синтетические задачи длинного контекста в LongContextQA | Megatron-LM, скрипты запуска в pretrain-code |
| SFT | Apertus-v1.5-SFT-mix (мультимодальная смесь SFT перечислена в отчёте) | posttraining-data, Megatron-LM (скрипты запуска SFT) |
| SFT с длинным контекстом | Подмножества смеси SFT (перечислены в отчёте), а также задачи LongContextQA | Megatron-LM |
| RL (RLVR) | Смесь, перечисленная в отчёте | verl, verl-recipe |
| DPO | Apertus-v1.5-Preference-Pool (аннотированные ответы), Apertus-v1.5-Preference-Data (пары) | posttraining, verl |
| SDPO (согласование с хартией, только 8B) | gretelai/gretel-safety-alignment-en-v1 | self-distillation |
Доступность моделей
Proton Lumo и Infomaniak Euria — два широко используемых приложения, недавно интегрировавших Apertus 1.5. Эти внедрения, наряду с другими, перечислены в витрине сообщества; предварительный просмотр доступен в этой теме обсуждения.
О доступе к Apertus 1.5 в форме API для разработчиков объявили различные провайдеры, включая Swisscom, Infomaniak, Phoeniqs и другие компании, перечисленные в нашем руководстве по общедоступности. В отчёте также приведены сведения о нашей работе с внешними оценщиками по тестированию и подготовке моделей.
Технические инструкции по запуску моделей находятся в карточках моделей выпусков Apertus на Hugging Face и в нашем кратком руководстве.
Как принять участие
Спасибо, что прочитали эту публикацию и стали частью нашего сообщества! Согласно аналитике Hugging Face, мы только что отметили пять миллионов скачиваний 🤗 и не собираемся сбавлять темп. На недавнем саммите AI+X в Цюрихе наша команда объявила о планах Apertus 2.0: разреженная архитектура/MoE, около 600 млрд параметров, расширенный график обучения, а приоритетами станут агенты, математика и программирование.
Итак, мы приглашаем вас прочитать наш отчёт, скачать модели, изучить промежуточные контрольные точки, дообучить веса и воспроизвести наши оценки. Мы всегда рады вопросам, ответы на которые ещё не представлены в наших публикациях или в разделе часто задаваемых вопросов на сайте; нам также будет интересно узнать, какие темы были бы наиболее полезны сообществу для будущих подробных разборов.
Если вы создаёте проекты с Apertus или используете его, заполните форму витрины и свяжитесь с нами через варианты на нашей контактной странице. Мы с нетерпением ждём возможности рассказать о новых проектах, узнать, что вы создаёте, и услышать, как можно улучшить Apertus!
Цитирование
Project Apertus и др. «Apertus 1.5: From Open Text Models to Open Multimodal Reasoners». arXiv:2610.15542. Препринт, arXiv, 11 октября 2026 года. https://doi.org/10.48550/arXiv.2610.15542.
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and Yassine Turki and Vinko Sabolčec and Valentina Pyatkin and Tommy Chu and Sven Najem-Meyer and Sean F. Carroll and Robert Smith and Raphael Kreft and Oscar Alessandro Tazza and Oleg Lavrovsky and Nicola Irmiger and Matteo Santelmo and Marian Schneider and Juan García Giraldo and Hanna Yukhymenko and Eduard Ďurech and Davit Melikidze and Dani Tamayo and Bettina Messmer and Aryan Ahadinia and Anunay Yadav and Allen Huang and Ahmad Fraij and Alessandro Bombarda and Alex Padula and Alexander Hägele and Alexander Sternfeld and Anna Hedström and Anna Kosovskaia and Arthur Wuhrmann and Arundhati Balasubramaniam and Badr Al Mahouri and Barna Pasztor and Bartosz Szostakiewicz and Bich Ngoc Doan and Bryan Schmid and Burak Sezen and Camille Challier and Clément Charmillot and Dana Shayakhmetova and Daniel Perruchoud and David Brüggemann and David Isztl and Elia Palme and Emma Anastassova and Fabian Bösch and Faruk Zahiragić and Fawzi Roberto Mohamed and Fiona Panicali and Florian Kolly and Flynn Guerra and Francesco Monti and Frederike Lübeck and Gennaro Oliva and Haofeng Yang and Haoliang Shang and Helen El Khoury and Henrique Mendonça and Jannis Vamvas and Jérome Landolt and Jessica Lam and Jingchun Xiao and Jonathan Coles and Joshua Oyebanji and Khanh Nguyen and Konstantinos Pitas and Lasse B. Strand and Li Mi and Loïc Deslarzes and Lorenzo Baggi and Lorenzo Noci and Luca Baumann and Luca Sartori and Lukas Drescher and Marco De Negri and Marco Passerini and Mark Klein and Marko Stojanovic and Martin Majsec and Matin Ansaripour and Mattea Busato and Mauro Pellonara and Max Neuwinger and Michael Graber and Michal Tešnar and Michelle Wastl and Miguel Gila and Mikolaj Boronski and Morgane Magnin and Moritz Reihs and Mukhammadali Sayfiddinov and Nathan Ranchin and Nicolas Cuveillier and Oscar Wohlfahrt and Qianqian Zou and Rada Kamysheva and Rita Sevastjanova and Roman Machacek and Sebastian Keller and Simon Matrenok and Simon Pierre and Stefano Schuppli and Suei-Wen Chen and Szabina Horváth-Mikulas and Taliesin Perez and Thilo Spinner and Thomas Kleine Buening and Tim Robinson and Tymoteusz Kwiecinski and Vilém Zouhar and Vinzenz Thoma and Xiaozhe Yao and Yannick Metz and Yuhei Fukuhara and Yusif Askari and Zixuan Chen and Alexander Ilic and Ana Klimovic and Andreas Krause and Andrei Kucharavy and Elliott Ash and Joost VandeVondele and Martin Rajman and Mennatallah El-Assady and Thomas Schulthess and Timo Kehrer and Torsten Hoefler and Antoine Bosselut and Martin Jaggi and Imanol Schlag},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}
Модели, упомянутые в этой статье 9
Наборы данных, упомянутые в этой статье 9
Статьи, упомянутые в этой статье 1
Коллекции, упомянутые в этой статье 2
Сообщество
· Зарегистрируйтесь или войдите, чтобы оставить комментарий


Модели, упомянутые в этой статье 9
Наборы данных, упомянутые в этой статье 9
Статьи, упомянутые в этой статье 1
Коллекции, упомянутые в этой статье 2
Переведено автоматически с английского. Оригинал статьи — по ссылке ниже.