Примітки до випуску Apertus 1.5


Apertus 1.5 — це продовження попереднього навчання моделі першого покоління: до моделі 8B додано 4 трильйони токенів текстових і мультимодальних навчальних даних, а до моделі 70B — 2 трильйони токенів, що загалом становить відповідно 19T і 17T. Як і всі випуски Apertus, моделі повністю відкриті: відкриті ваги, відкриті дані, відкриті цінності та повні деталі навчання.
Ключові вдосконалення
- Вбудоване мультимодальне розуміння: Apertus 1.5 приймає зображення й аудіо поряд із текстом, додаючи до діалогу документи, діаграми та фотографії. Моделі також можуть обробляти усне мовлення, хоча ця можливість залишається експериментальною.
- Режим міркування: Моделі можна перемкнути в режим міркування, щоб вони аналізували вхідні дані перед відповіддю, що покращує результати на завданнях, які потребують міркування.
- Довгий контекст: Контекстне вікно збільшено до 262 144 токенів — у 4 рази порівняно з Apertus 1.0.
- Покращене виконання інструкцій: Краще дотримання інструкцій, ніж у Apertus 1.0, забезпечує передбачуваніші й точніші відповіді.
- Покращене використання інструментів: Моделі навчені краще інтегрувати інструменти, що дає змогу ефективніше використовувати зовнішні інструменти й API.
- Відкриті цінності: Суворіше дотримання Хартії Apertus забезпечує прозорість цінностей і принципів моделі.
Процес навчання
 Повний навчальний процес Apertus 1.5
Мультимодальність через токенізатор
У моделях v1.5 ми впроваджуємо мультимодальність у режимі раннього об’єднання: зображення й аудіо надходять до Apertus як дискретні токени в тій самій послідовності, що й текстові токени, замість використання окремого візуального енкодера. Зображення токенізуються за допомогою токенізатора Emu3.5 (зображення 512×512 перетворюється на 1 024 токени), а аудіо — за допомогою WavTokenizer (40 токенів на секунду). Ми лише розширюємо словник, тому архітектура залишається незмінною, а навчання відбувається зі швидкістю, характерною для роботи лише з текстом. Моделі розуміють зображення й аудіо, але генерують лише текст.

Попереднє навчання
Починаючи з Apertus 1.0, ми продовжуємо попереднє навчання у чотири етапи:
- Непарні дані: текст, а також окремі зображення й аудіо, щоб модель навчилася працювати з новими модальностями.
- Парні дані: пари зображення–підпис і аудіо–транскрипт, щоб модель узгодила їх із мовою.
- Охолодження: якісніші дані з більшою кількістю математики й коду.
- Довгий контекст: вікно поступово збільшується з 8k до 262k токенів.
Загалом більше половини навчальних токенів є текстовими, що зберігає мовні здібності Apertus 1.0. Текстові дані оновлюються такими джерелами, як FineWeb2-HQ+, FinePDFs і Nemotron-CC. Усі нові дані, зокрема мультимодальні, відповідають тим самим вимогам, що й раніше: вони є загальнодоступними, мають дозвільні ліцензії, а відмови через robots.txt враховано заднім числом. Усі джерела перелічено в apertus-data-transparency.
Післянавчання
Післянавчання відбувається у п’ять етапів: SFT → SFT із довгим контекстом → RL → DPO → узгодження з хартією (SDPO).
- SFT на 3,7 млн текстових прикладів, а також даних із зображеннями й мовленням. Траєкторії міркувань додаються лише до запитів, які модель не може розв’язати без них. Дані для використання інструментів обмежені траєкторіями, перевіреними виконанням. Ми публікуємо використану нами текстову суміш SFT на Hugging Face.
- SFT із довгим контекстом на повному вікні у 262k токенів відновлює здатність працювати з довгим контекстом, яку послаблює SFT із коротким контекстом.
- RL із перевірюваними винагородами (RLVR) приблизно на 350 тисячах математичних, програмних, мультимовних, мультимодальних запитів і запитів на виконання інструкцій, із поєднанням увімкненого та вимкненого режиму міркування.
- DPO із парами вподобань, оціненими суддею, покращує якість діалогів, використання інструментів і безпеку. Ми публікуємо пул уподобань і навчальні пари.
- SDPO узгоджує модель із Хартією Apertus за допомогою відгуків судді та самодистиляції.
Результати оцінювання
Поряд із розширенням можливостей моделей ми також суттєво розширили спектр оцінювань. На додачу до наявних текстових оцінювань, використаних для Apertus 1.0, ми додали мультимодальні оцінювання (зображення й аудіо) та оцінювання режиму міркування.
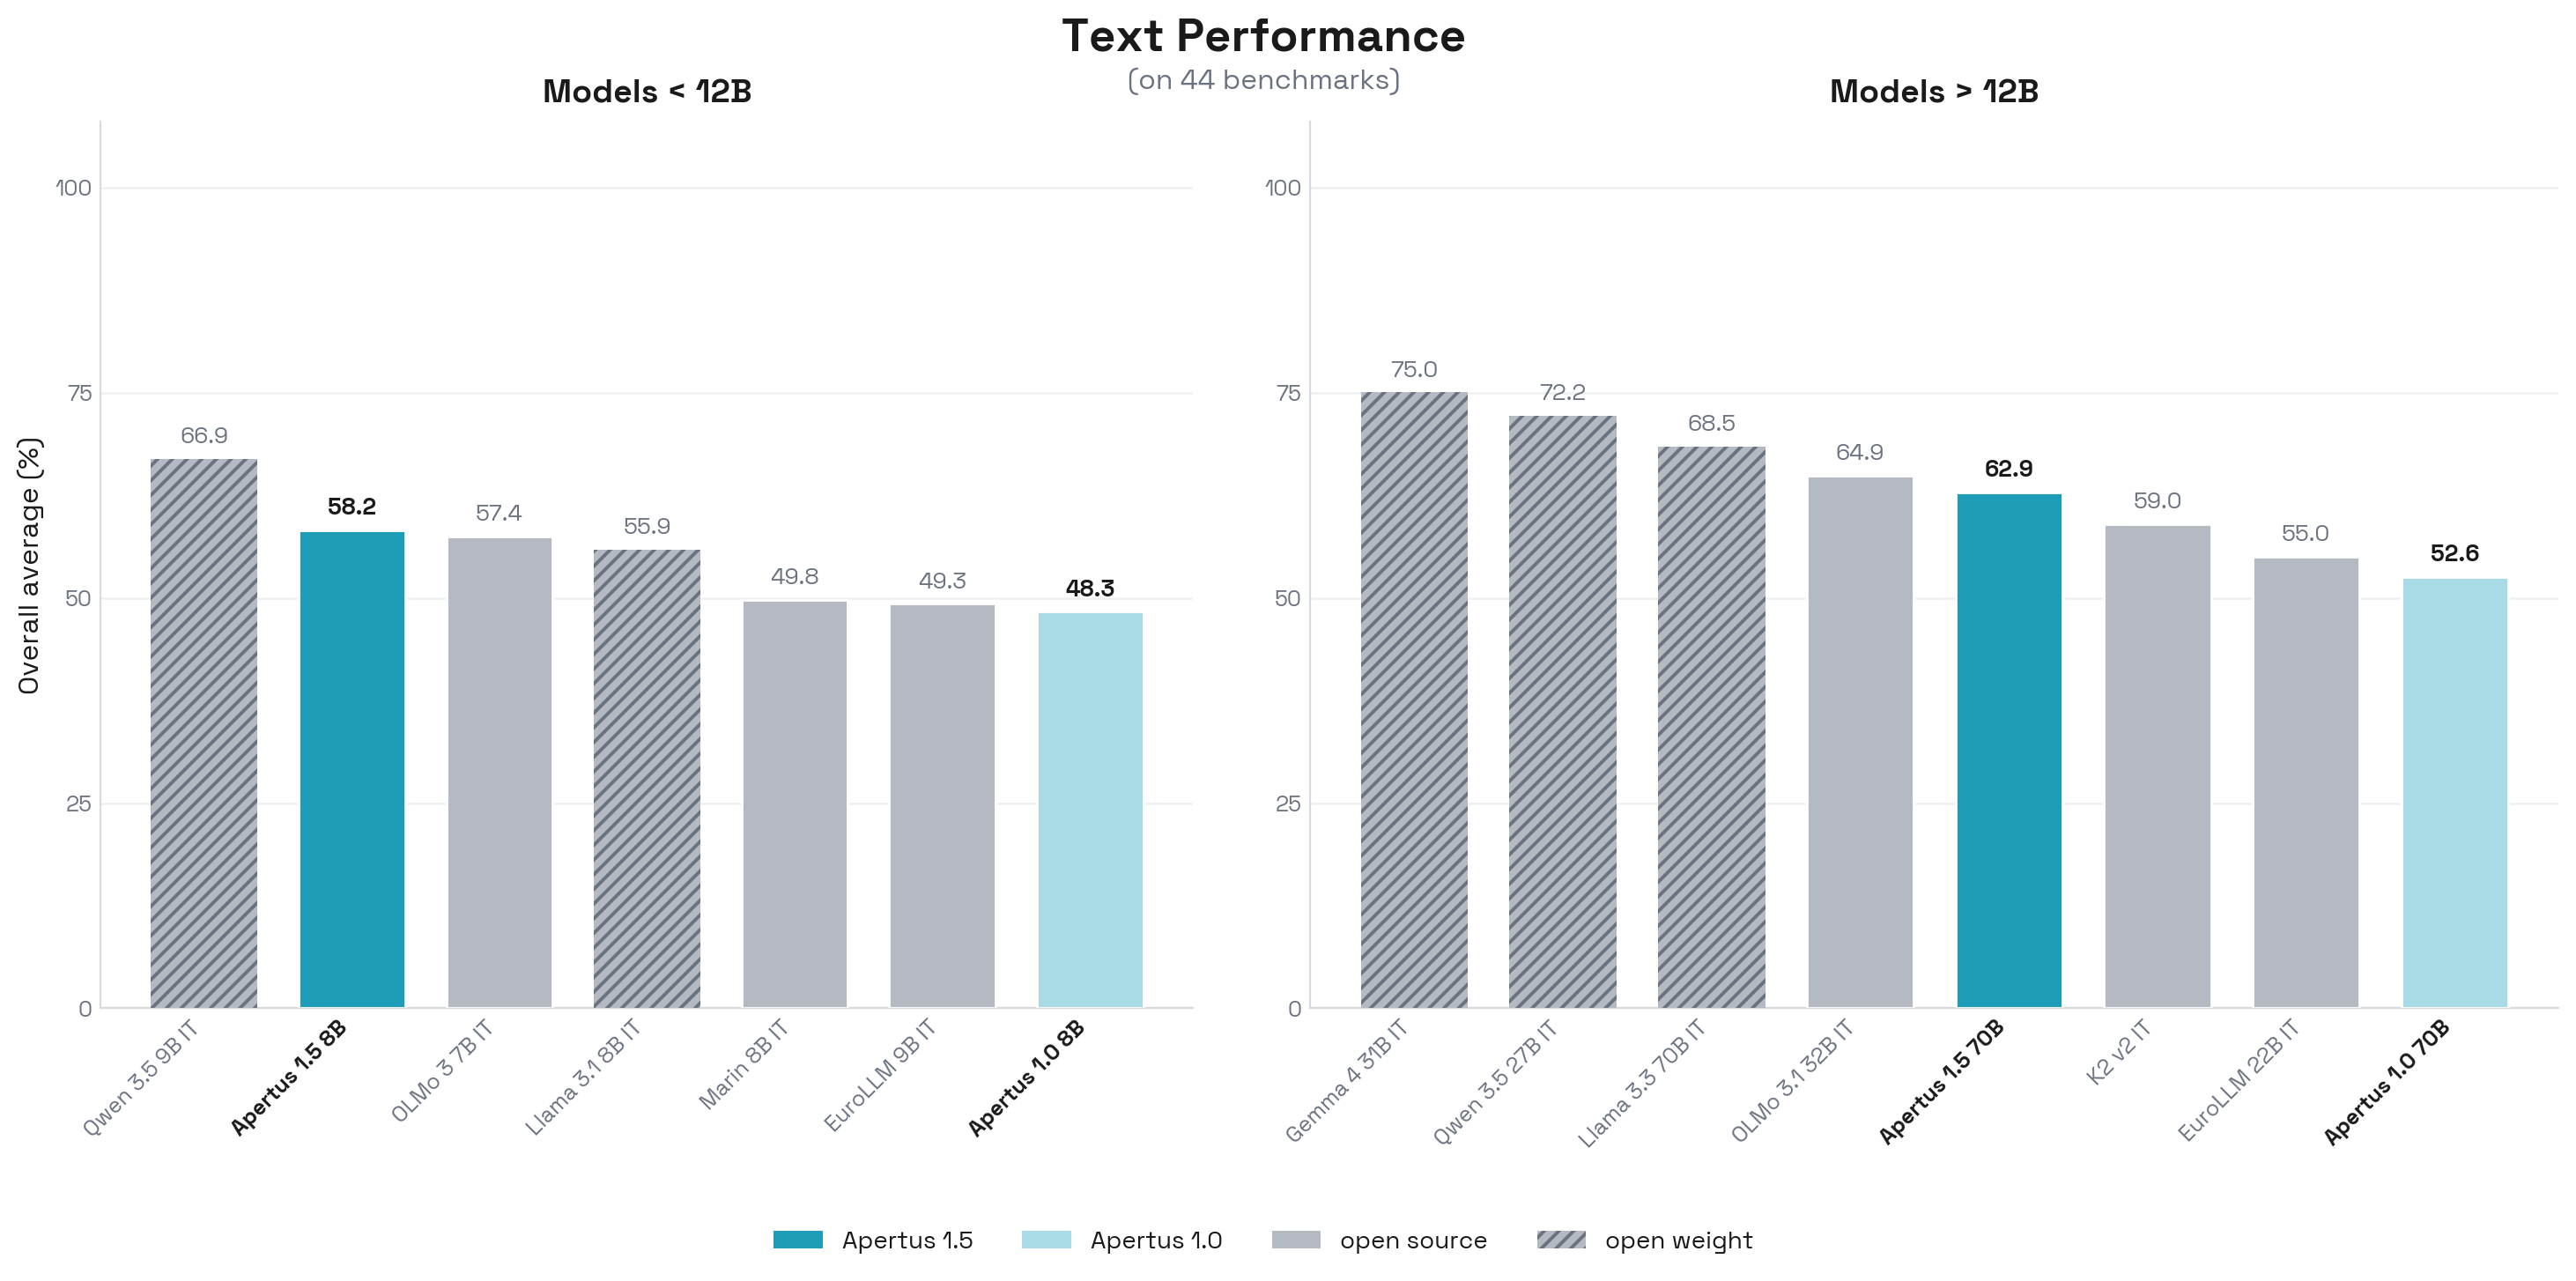
Мультимодальні оцінювання виконуються через конвеєр MLLM-eval-suite, який об’єднує два основні фреймворки мультимодального оцінювання — lmms-eval і VLMEvalKit. Ми також додали низку текстових бенчмарків і розширили бенчмаркінг перекладу та мультимовних можливостей, безпеки й використання інструментів. Їх можна знайти в нашому репозиторії оцінювань післянавчання, заснованому на форку lm-evaluation-harness.
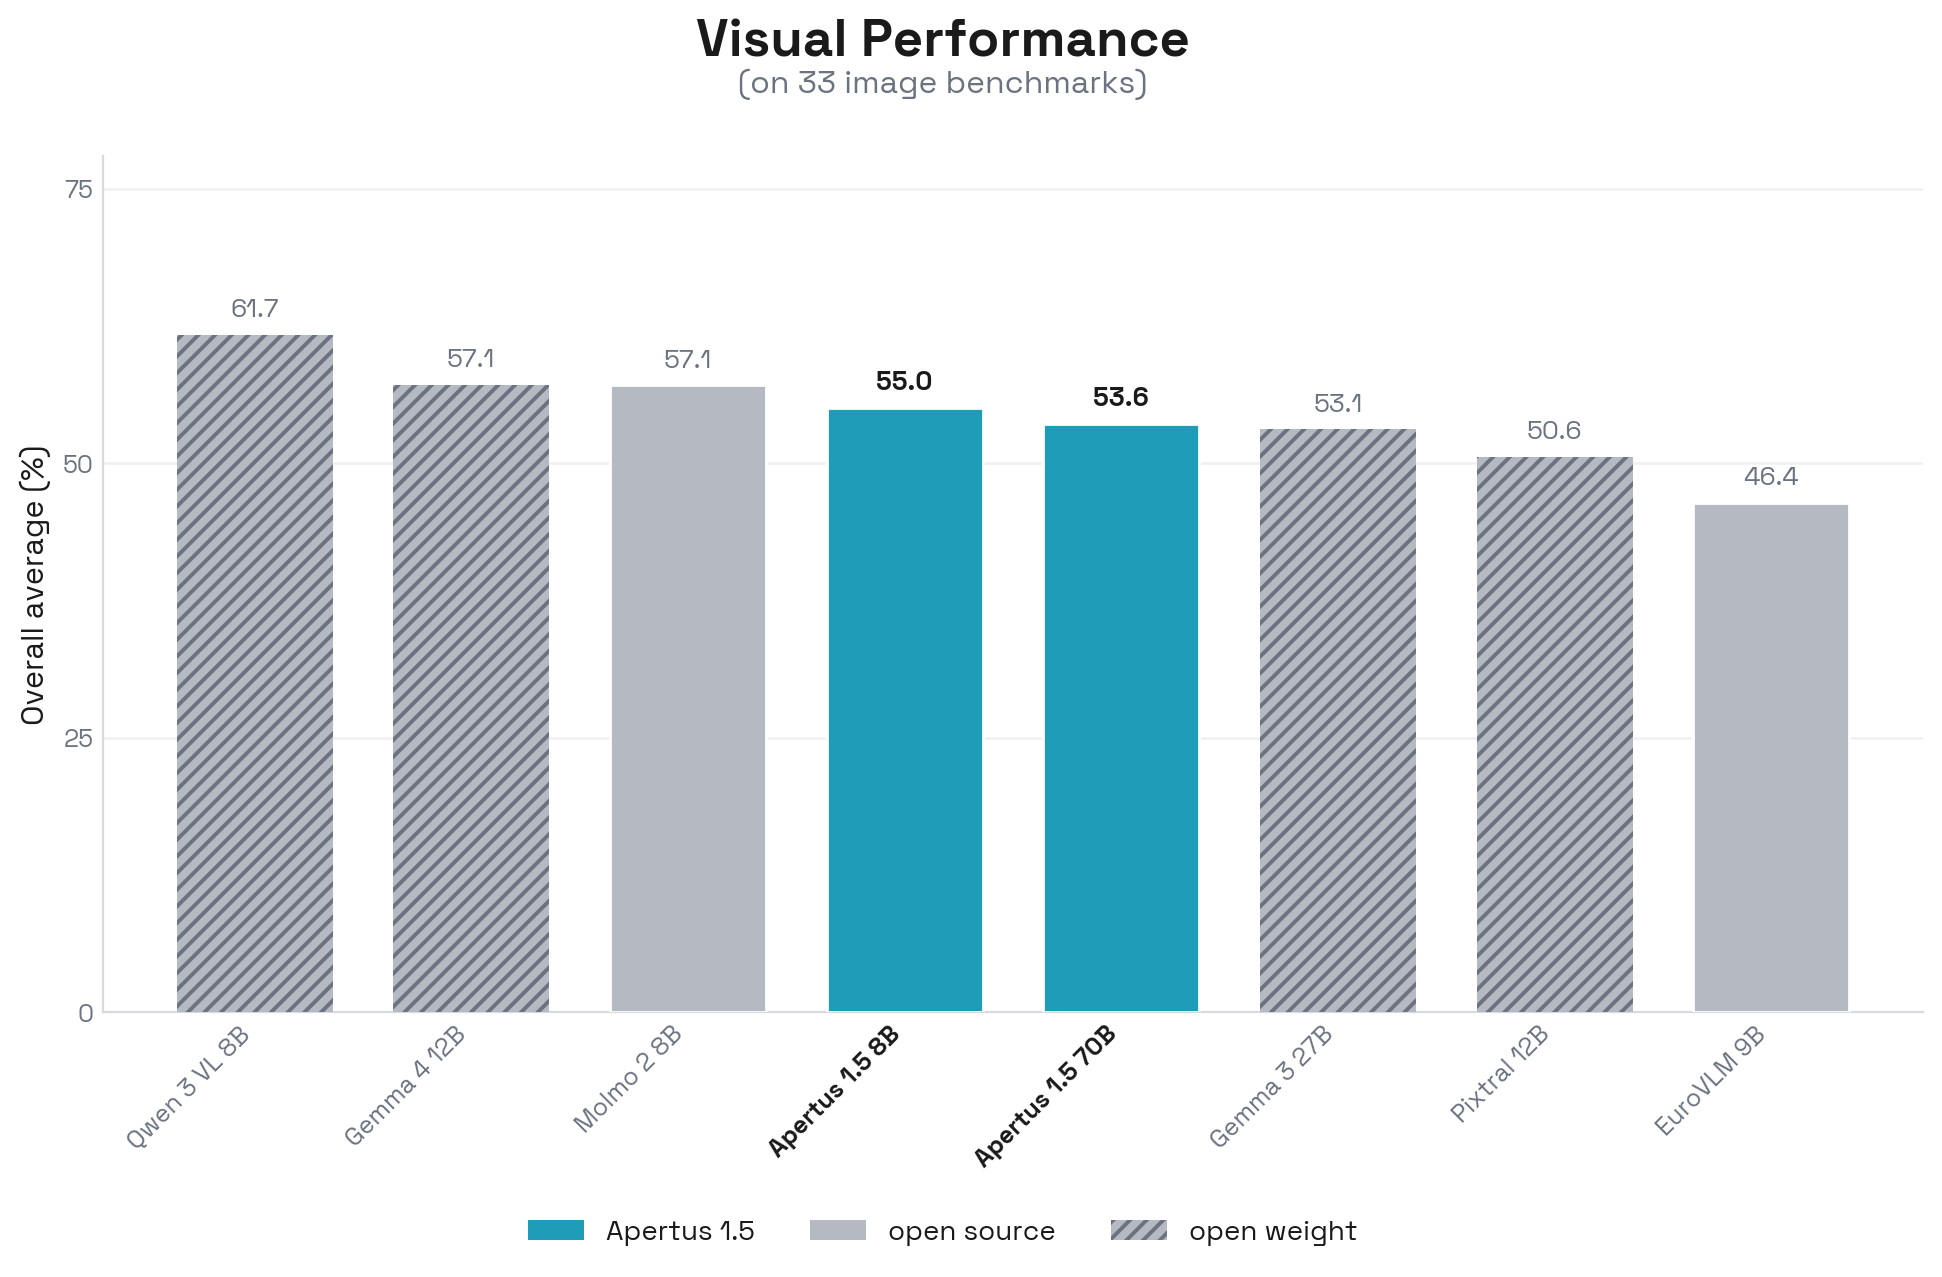
Хоча новий випуск усе ще поступається передовим моделям із відкритими вагами, він також суттєво покращив результати в програмуванні та виконанні інструкцій: Apertus 1.5 8B перевершує моделі з відкритими вагами аналогічного розміру в завданнях IF і мультимовних завданнях. Міркування додатково покращує результати на складних бенчмарках із переважанням міркувань, таких як AIME. Мультимодальні результати моделі ближчі до Gemma 4 12B та інших сучасних моделей із відкритими вагами. Мультимодальні результати Apertus 1.5 є конкурентними серед моделей із відкритими вагами в просторовому розумінні та серед моделей із відкритим кодом — у розумінні документів і діаграм.
Ми також дякуємо нашим співробітникам і зовнішнім оцінювачам за допомогу в ефективному бенчмаркінгу можливостей Apertus. Зокрема, Apertus 1.5 демонструє високі результати в завданнях Swiss Legal, перебуваючи на рівні провідних моделей із відкритими вагами (блог, код). Крім того, у Last Translation Benchmark модель Apertus 1.5 8B демонструє можливості машинного перекладу, співставні з GPT-OSS-20B, і перевершує такі моделі, як Claude Haiku 4.5 або Google Translate (таблиця лідерів, стаття).
Картки оцінювання: Apertus ❤️ EvalEval
Apertus співпрацює з коаліцією EvalEval, щоб забезпечити повністю прозорий і відтворюваний бенчмаркінг. Ми публікуємо результати Apertus 1.5 за схемою Every Eval Ever (EEE) — спільним форматом, який фіксує не лише оцінки, а й те, хто проводив оцінювання, як отримували доступ до моделі, параметри генерації та як слід інтерпретувати кожну метрику: деталі, яких зазвичай бракує в таблицях лідерів і які часто пояснюють відмінності між схожими оцінками.
Результати наведено в картці оцінювання Eval нижче. Вона об’єднує дані запуску з метаданими бенчмарку й моделі в один інтерпретований запис; результати також доступні через Community Evals Hugging Face. Це та сама інфраструктура, яку Інститут безпеки ШІ Великої Британії використовує для відкритої публікації своїх оцінювань. Оскільки наші текстові оцінювання виконуються на нашому публічному форку lm-evaluation-harness, який EEE підтримує спеціальним конвертером, кожен може повторно запустити їх і порівняти свої результати з нашими за ідентичних налаштувань.
Структуроване звітування про оцінювання важливе не лише для досліджень. EvalEval зіставив картки оцінювання з вимогами до управління ШІ, зокрема зі статтею 55 Закону ЄС про ШІ та Кодексом практик GPAI, і встановив, що схема EEE може представити 56 із 60 елементів звітування про оцінювання, передбачених цими документами. Це відповідає тому, як ми вже випускаємо Apertus: разом із моделями ми публікуємо публічний звіт про навчальний контент і добровільно — документ Кодексу практик. Машиночитні записи оцінювання є природним наступним кроком: вони спрощують для регуляторів, розробників і дослідників пошук, інтерпретацію та порівняння доказів, що лежать в основі моделі.
Ми прагнемо сприяти відтворюваному й прозорому оцінюванню за допомогою карток Eval і схеми EEE та закликаємо інших розробників моделей звітувати про свої результати так само, щоб оцінки можна було порівнювати між моделями й організаціями.
Відтворюваність Apertus 1.5
Усі рецепти, абляції та суміші даних задокументовано в технічному звіті. Ми прагнемо популяризувати розробку відкритих моделей, зробивши процес навчання v1.5 публічним і доступним. Проміжні контрольні точки розміщено в нашій колекції Apertus 1.5 на Hugging Face, зокрема базові ваги, SFT, RLVR і DPO, а також підібрані суміші навчальних даних і спеціальні набори даних у колекції наборів даних Apertus 1.5. Їхнє поширення дає змогу дослідникам вивчати, як кожен етап змінює поведінку моделі.
Звіт охоплює численні абляції впливу даних післянавчання на різних етапах. Ми виявили, що мультимодальні дані, змішані з текстовими під час SFT, допомагають покращити результати в усіх модальностях. Також ми з’ясували, що переваги мультимодальних траєкторій міркувань зберігаються після подальшого текстового навчання з підкріпленням: якщо почати з контрольної точки SFT, навченої на мультимодальних траєкторіях, RL покращує математичні здібності сильніше, ніж у разі початку з текстової контрольної точки, а перевага в завданнях на міркування зберігається протягом усього навчання.
| Моделі | 8B | 70B |
|---|---|---|
| Попереднє навчання (базова модель із довгим контекстом) | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| Контрольоване донавчання (SFT) | Apertus-v1.5-8B-SFT | Apertus-v1.5-70B-SFT |
| Навчання з підкріпленням (RLVR) | Apertus-v1.5-8B-RLVR | Apertus-v1.5-70B-RLVR |
| Узгодження вподобань (DPO) | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B (фінальна) |
| Узгодження з хартією (SDPO) | Apertus-v1.5-8B (фінальна) | – |
| Етап | Дані | Код / рецепт |
|---|---|---|
| Попереднє навчання: етапи 1–2 (непарні, парні) | Усі джерела з версіями й ліцензіями в apertus-data-transparency; рецепти обробки зображень і аудіо в multimodal-data | Megatron-LM, скрипти запуску в pretrain-code, apertus-omni-tokenizer, benchmark-image-tokenizer, benchmark-audio-tokenizer (зокрема засіб побудови чергованого мовлення–тексту) |
| Попереднє навчання: етап 3 (охолодження) | apertus-data-transparency; підібрані набори зображень NASA, Our World in Data, Smithsonian, swisstopo | Megatron-LM, скрипти запуску в pretrain-code |
| Розширення довгого контексту | apertus-data-transparency; синтетичні завдання з довгим контекстом у LongContextQA | Megatron-LM, скрипти запуску в pretrain-code |
| SFT | Apertus-v1.5-SFT-mix (мультимодальна суміш SFT, наведена у звіті) | posttraining-data, Megatron-LM (скрипти запуску SFT) |
| SFT із довгим контекстом | Підмножини суміші SFT (наведені у звіті), а також завдання LongContextQA | Megatron-LM |
| RL (RLVR) | Суміш, наведена у звіті | verl, verl-recipe |
| DPO | Apertus-v1.5-Preference-Pool (анотовані завершення), Apertus-v1.5-Preference-Data (пари) | posttraining, verl |
| SDPO (узгодження з хартією, лише 8B) | gretelai/gretel-safety-alignment-en-v1 | self-distillation |
Доступність моделей
Proton Lumo і Infomaniak Euria — два широко використовувані застосунки, які нещодавно інтегрували Apertus 1.5. Серед інших ці розгортання перелічено в спільнотній вітрині; попередній перегляд доступний у цій гілці обговорення.
Доступ до Apertus 1.5 у формі API для розробників оголосила низка постачальників, зокрема Swisscom, Infomaniak, Phoeniqs та інші компанії, перелічені в нашому посібнику із загальної доступності. У звіті також наведено деталі нашої співпраці із зовнішніми оцінювачами для тестування й підготовки моделей.
Технічні інструкції із запуску моделей наведено в картках моделей випусків Apertus на Hugging Face і в нашому посібнику для швидкого старту.
Як долучитися
Дякуємо, що прочитали цю публікацію в блозі та є частиною нашої спільноти! Ми щойно відсвяткували п’ять мільйонів завантажень у нашій аналітиці Hugging Face 🤗 і не збираємося сповільнюватися. На нещодавньому саміті AI+X у Цюриху наша команда оголосила дорожню карту Apertus 2.0: розріджена/MoE-архітектура, приблизно 600B загальних параметрів, розширений графік навчання, а пріоритетами будуть агенти, математика й програмування.
Підсумовуючи: ми запрошуємо вас прочитати наш звіт, завантажити моделі, дослідити проміжні контрольні точки, донавчити ваги та відтворити наші оцінювання. Ми завжди раді запитанням, на які ще немає відповіді в наших публікаціях або розділі поширених запитань на сайті, а також хотіли б почути, які теми були б найкориснішими для спільноти в майбутніх детальних матеріалах.
Якщо ви створюєте щось за допомогою Apertus або використовуєте його, заповніть, будь ласка, форму для вітрини та зв’яжіться з нами через варіанти на нашій сторінці контактів. Ми з нетерпінням чекаємо нагоди висвітлити більше робіт, дізнатися, що ви створюєте, і почути, як можна вдосконалити Apertus!
Цитування
Project Apertus та ін. «Apertus 1.5: From Open Text Models to Open Multimodal Reasoners». arXiv:2610.15542. Препринт, arXiv, 11 жовтня 2026 року. https://doi.org/10.48550/arXiv.2610.15542.
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and Yassine Turki and Vinko Sabolčec and Valentina Pyatkin and Tommy Chu and Sven Najem-Meyer and Sean F. Carroll and Robert Smith and Raphael Kreft and Oscar Alessandro Tazza and Oleg Lavrovsky and Nicola Irmiger and Matteo Santelmo and Marian Schneider and Juan García Giraldo and Hanna Yukhymenko and Eduard Ďurech and Davit Melikidze and Dani Tamayo and Bettina Messmer and Aryan Ahadinia and Anunay Yadav and Allen Huang and Ahmad Fraij and Alessandro Bombarda and Alex Padula and Alexander Hägele and Alexander Sternfeld and Anna Hedström and Anna Kosovskaia and Arthur Wuhrmann and Arundhati Balasubramaniam and Badr Al Mahouri and Barna Pasztor and Bartosz Szostakiewicz and Bich Ngoc Doan and Bryan Schmid and Burak Sezen and Camille Challier and Clément Charmillot and Dana Shayakhmetova and Daniel Perruchoud and David Brüggemann and David Isztl and Elia Palme and Emma Anastassova and Fabian Bösch and Faruk Zahiragić and Fawzi Roberto Mohamed and Fiona Panicali and Florian Kolly and Flynn Guerra and Francesco Monti and Frederike Lübeck and Gennaro Oliva and Haofeng Yang and Haoliang Shang and Helen El Khoury and Henrique Mendonça and Jannis Vamvas and Jérome Landolt and Jessica Lam and Jingchun Xiao and Jonathan Coles and Joshua Oyebanji and Khanh Nguyen and Konstantinos Pitas and Lasse B. Strand and Li Mi and Loïc Deslarzes and Lorenzo Baggi and Lorenzo Noci and Luca Baumann and Luca Sartori and Lukas Drescher and Marco De Negri and Marco Passerini and Mark Klein and Marko Stojanovic and Martin Majsec and Matin Ansaripour and Mattea Busato and Mauro Pellonara and Max Neuwinger and Michael Graber and Michal Tešnar and Michelle Wastl and Miguel Gila and Mikolaj Boronski and Morgane Magnin and Moritz Reihs and Mukhammadali Sayfiddinov and Nathan Ranchin and Nicolas Cuveillier and Oscar Wohlfahrt and Qianqian Zou and Rada Kamysheva and Rita Sevastjanova and Roman Machacek and Sebastian Keller and Simon Matrenok and Simon Pierre and Stefano Schuppli and Suei-Wen Chen and Szabina Horváth-Mikulas and Taliesin Perez and Thilo Spinner and Thomas Kleine Buening and Tim Robinson and Tymoteusz Kwiecinski and Vilém Zouhar and Vinzenz Thoma and Xiaozhe Yao and Yannick Metz and Yuhei Fukuhara and Yusif Askari and Zixuan Chen and Alexander Ilic and Ana Klimovic and Andreas Krause and Andrei Kucharavy and Elliott Ash and Joost VandeVondele and Martin Rajman and Mennatallah El-Assady and Thomas Schulthess and Timo Kehrer and Torsten Hoefler and Antoine Bosselut and Martin Jaggi and Imanol Schlag},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}
Моделі, згадані в цій статті 9
Набори даних, згадані в цій статті 9
Статті, згадані в цій статті 1
Колекції, згадані в цій статті 2
Спільнота
· Зареєструйтеся або увійдіть, щоб залишити коментар


Моделі, згадані в цій статті 9
Набори даних, згадані в цій статті 9
Статті, згадані в цій статті 1
Колекції, згадані в цій статті 2
Перекладено автоматично з англійської. Оригінал статті — за посиланням нижче.